
Article body
正文
大模型擅长理解目标和生成计划,企业系统则依赖确定的接口、参数和状态。两者之间需要一个可治理执行面。CLI适合Agent调用,因为命令结构清晰、输入输出可以序列化,也容易进入现有脚本、容器和审计体系。
Skills把业务语言映射到命令
一个面向Agent的CLI不应只暴露几百条孤立命令。Skills可以按数据、权限、仪表盘和工作流组织能力,说明前置条件、参数约束和失败处理。Agent先选择业务技能,再调用具体命令,减少把“授权用户查看看板”误解成“修改看板公开范围”的风险。
命令还需要稳定的结构化输出。成功结果返回资源ID、状态和下一步;失败结果区分权限不足、参数错误、网络超时和业务冲突。Agent据此决定修正参数、请求授权或停止任务。把人类可读日志当作唯一接口,会迫使模型猜测错误含义。
Dry Run让写操作先被看见
Agent准备创建、修改或删除资源时,Dry Run先计算影响范围。用户可以看到目标对象、权限变化、预计调用和不可逆风险,再决定是否执行。系统也能在这一阶段检查策略,例如禁止跨租户共享、限制批量导出、要求生产环境审批。
Dry Run的结果应该带签名或版本标识。正式执行时,平台确认资源状态没有变化;如果目标在预览后被别人修改,Agent重新生成预览,避免按旧计划覆盖新内容。
SSE提供长任务反馈
建模、批量查询和工作流可能持续数十秒或更久。SSE可以持续回传计划、进度、工具结果和错误,让用户知道任务卡在哪里。事件至少包含任务ID、步骤ID、时间、状态和可读说明,客户端可以重连并从上次位置继续接收。
进度流也帮助审计。团队能够还原Agent在某一步使用了哪个参数,为什么进入重试,以及用户何时批准了写操作。敏感字段在进入日志前需要脱敏,令牌与密钥不能出现在事件内容中。
执行面需要四条硬约束
- 每条命令都有明确Schema,Agent不能拼接任意脚本。
- 每次调用都使用当前用户与租户权限,工具不能继承超额服务账号权限。
- 写操作支持预览、审批、幂等和回滚,失败后不会留下未知状态。
- 长任务提供进度、取消与审计,用户可以随时接管。
模型会更新,执行合同需要保持稳定。企业把业务能力封装为受治理的CLI与API后,可以替换上层模型,也可以让不同Agent复用同一套安全工具。Agent的生产价值由可完成、可观察和可追责的任务决定。
工程细节与实施补充
1. 背景与问题域
1.1 AI Agent在BI场景中的执行困境
随着Claude Code、Codex等编码代理的崛起,以及OpenClaw、Hermes Agent等常驻型Agent的普及,AI Agent正在进入企业级数据分析的深水区。然而,当这些Agent尝试与BI系统交互时,一个根本性的矛盾浮现出来:BI系统的API表面往往庞大而复杂,而Agent的推理窗口有限、容错能力弱。
传统的BI API调用模式存在以下几类典型问题:
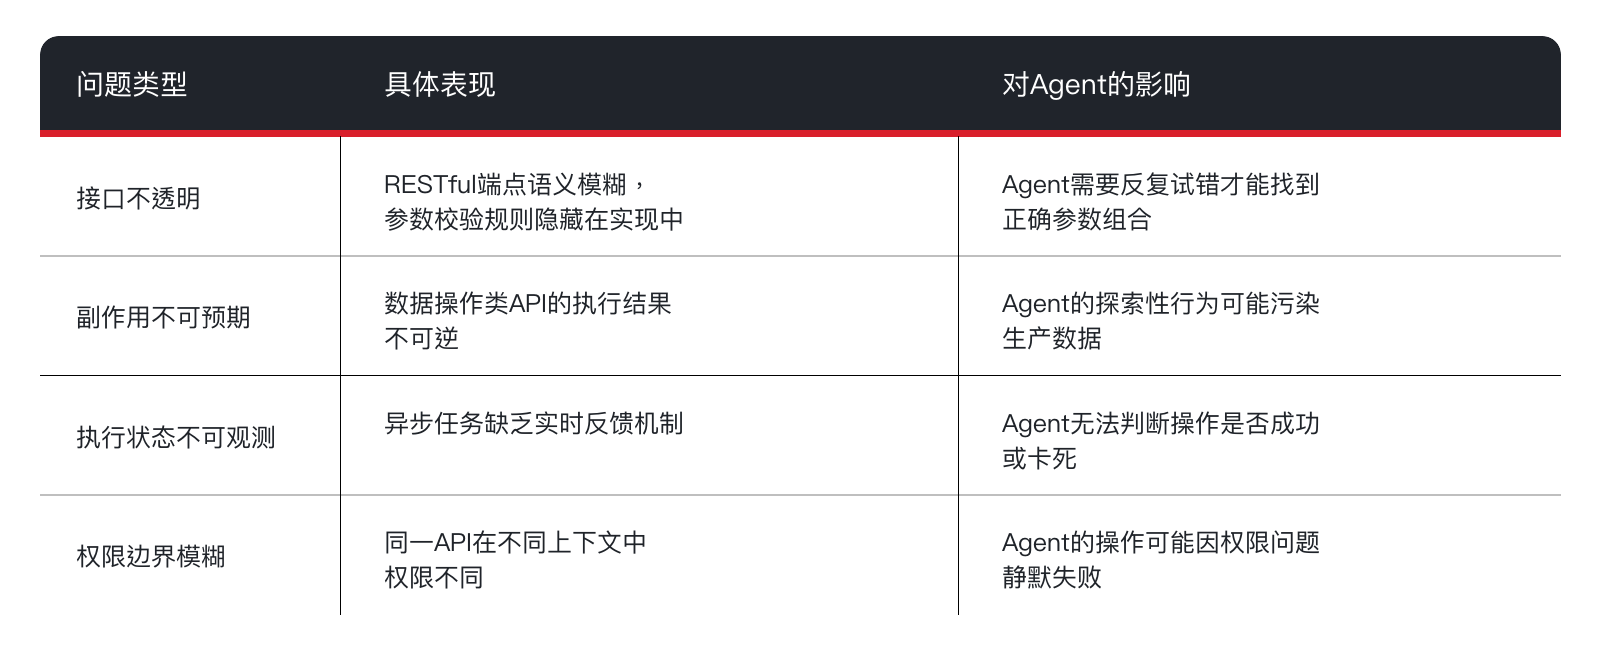
这些问题在面向人类的CLI设计中尚可接受:人类可以通过文档、错误提示和交互式确认来弥补API的不完美。但对于一个完全依赖推理和代码生成的Agent而言,这些设计缺陷会被指数级放大,最终导致Agent在BI任务上的成功率远低于预期。
1.2 HENGSHI CLI的定位
HENGSHI CLI正是在这一背景下应运而生。它的核心定位是:给编码代理与常驻型Agent的BI执行层。这不是一个面向人类用户的传统CLI,而是一个面向AI Agent的工程化接口层,其设计目标与传统CLI有本质区别:
┌─────────────────────────────────────────────────────────────┐
│                    Agentic BI 三位一体架构                    │
├─────────────────────────────────────────────────────────────┤
│                                                             │
│   ┌─────────────┐    ┌─────────────┐    ┌─────────────┐    │
│   │    Agent    │───▶│     CLI     │───▶│  Headless   │    │
│   │   推理层     │    │   执行层     │    │    引擎      │    │
│   └─────────────┘    └─────────────┘    └─────────────┘    │
│         │                  │                  │            │
│         │           稳定化的命令树          低延迟API       │
│         │           Skills路由               查询路由       │
│         │           Dry-Run治理              缓存优化       │
│         │           SSE回显                                     │
│                                                             │
└─────────────────────────────────────────────────────────────┘在这个架构中,CLI承担的是执行层的职责:它接收Agent发出的高层意图(如“创建一个华东区域驾驶舱仪表板”),通过Skills路由将其分解为稳定的命令序列,并以Dry-Run和SSE机制确保整个过程可预测、可审查。
2. 核心特性解析
HENGSHI CLI的三大核心特性:Skills路由、Dry-Run治理与SSE回显:并非孤立的功能点,而是共同构成了一个面向Agent的BI操作保障体系。
2.1 Skills路由体系
传统的CLI工具通常提供一组扁平的命令,命令之间缺乏语义关联,Agent需要自行理解每个命令的含义和依赖关系。HENGSHI CLI引入了Skills路由体系,将BI操作按照语义和职责边界划分为三个独立的Skill层:
2.1.1 层次结构概览
┌──────────────────────────────────────────────────────────────┐
│                    Skills Router (路由层)                     │
├──────────────────────────────────────────────────────────────┤
│                                                              │
│  ┌─────────────────┐  ┌─────────────────┐  ┌──────────────┐ │
│  │  everest-core   │  │  everest-data   │  │everest-workflow││
│  │   (核心技能)     │  │   (数据技能)     │  │  (工作流技能)  ││
│  └────────┬────────┘  └────────┬────────┘  └──────┬───────┘│
│           │                    │                   │        │
│    规范化术语处理         资源定位处理          编排协调处理    │
│    认证与会话管理         app/dataset/model      跨域执行      │
│           │                    │                   │        │
└───────────┼────────────────────┼───────────────────┼────────┘
            ▼                    ▼                   ▼
2.1.2 everest-core:规范化与认证
everest-core 是整个Skills体系的基础层,负责处理所有BI操作都需要的基础能力:
- 规范化术语处理:将Agent发出的自然语言描述转换为系统内部的标准术语。例如,当Agent说“列出所有报表”时,core层会将其规范化为对
report资源的list操作;当Agent提到“数据集”时,core层会确保其指向dataset而非datasource。 - 认证与会话管理:维护与衡石BI平台的连接状态,处理OAuth令牌刷新、会话续期等逻辑。Agent无需关心认证细节,只需确保请求带有有效的会话上下文。
- 通用元数据操作:如获取当前租户信息、查询可用操作列表等元查询能力。
# everest-core 内部术语映射示例
TERM_NORMALIZATION = {
    "报表": "report",
    "报告": "report",
    "dashboard": "dashboard",
    "仪表板": "dashboard",
    "数据集": "dataset",
    "数据源": "datasource",
    "模型": "model",
    "应用": "app",
    "应用": "application"
}
2.1.3 everest-data:资源定位与操作
everest-data 负责BI系统中最核心的资源操作,包括应用(app)、数据集(dataset)和数据模型(model)的CRUD操作。这一层的设计重点是资源定位的确定性:给定一个模糊的描述,如何唯一确定目标资源。
# 资源定位的典型场景
$ everest dataset list --app retail-ops --output json

# 返回结构
{
  "datasets": [
    {
      "id": "ds_001",
      "name": "销售明细表",
      "app_id": "app_retail_ops",
      "created_at": "2026-03-15T10:30:00Z",
      "schema": { "columns": 42, "rows": 1250000 }
    },
    {
      "id": "ds_002",
      "name": "客户画像表",
      "app_id": "app_retail_ops",
      "created_at": "2026-03-18T14:22:00Z",
      "schema": { "columns": 28, "rows": 850000 }
    }
  ],
  "total": 2,
  "page_token": null
}资源定位的关键挑战在于同名资源的歧义消解。当一个Agent发出“获取销售数据”这样的请求时,可能存在多个包含“销售”字样的数据集。everest-data通过以下策略解决这一问题:
- 上下文优先级:利用会话上下文中的最近访问应用(app)来缩小搜索范围
- 标签匹配:支持通过元数据标签进行精确过滤
- 模糊匹配评分:当精确匹配不存在时,返回按相关度排序的候选列表
2.1.4 everest-workflow:跨域执行编排
everest-workflow 是最高层的Skill,负责处理涉及多个资源、多个步骤的复杂BI操作。这类操作在传统CLI中往往需要Agent自行拼接多个命令,而everest-workflow提供了声明式的编排能力:
# 创建一个完整的仪表板工作流
$ everest workflow execute --manifest华东驾驶舱创建流程.json --dry-run

# manifest示例结构
{
  "name": "华东驾驶舱创建流程",
  "steps": [
    {
      "skill": "everest-data",
      "action": "dataset.query",
      "params": {
        "app": "retail-ops",
        "dataset": "销售明细表",
        "filters": { "region": "华东" }
      }
    },
    {
      "skill": "everest-data",
      "action": "model.create",
      "params": {
        "name": "华东销售分析模型",
        "dataset": "销售明细表(华东)",
        "metrics": ["sum(revenue)", "count(orders)", "avg(order_value)"]
      }
    },
    {
      "skill": "everest-data",
      "action": "dashboard.create",
      "params": {
        "app": "retail-ops",
        "title": "华东区域驾驶舱",
        "model": "华东销售分析模型"
      }
    }
  ]
}workflow层的核心价值在于原子性与事务性。每个步骤可以独立执行,失败时支持从断点恢复;整体流程支持事务语义,确保要么全部成功,要么全部回滚。
3. Dry-Run治理机制
3. Dry-Run治理机制
3.1 为什么Agent需要Dry-Run
对于人类用户而言,CLI操作前可以看一眼命令、确认一下参数,感觉不对还能Ctrl+C取消。但Agent执行的是一个完整的代码生成-执行循环,它可能会在毫秒级时间内连续发出多个API请求,而这些请求的执行效果:尤其是数据变更类操作:往往是不可逆的。
Dry-Run(预演模式) 正是为解决这一问题而设计的。它的核心理念是:在真正执行之前,先用只读的方式模拟整个操作流程,让Agent和运维人员都能看清将要发生什么。
3.2 Dry-Run的技术实现
HENGSHI CLI的Dry-Run机制并非简单的“预览”:它是一个完整的安全治理层,包含以下几个关键组件:
3.2.1 操作影响分析
当Agent发出一个操作请求时,Dry-Run会首先分析该操作可能产生的影响:
# 授权操作的Dry-Run
$ everest authorize grant \
    --target-type app \
    --target-id app_42 \
    --user 123:editor \
    --dry-run

# 输出
┌─────────────────────────────────────────────────────────────┐
│                      DRY-RUN PREVIEW                        │
├─────────────────────────────────────────────────────────────┤
│ Operation: authorize.grant                                  │
│                                                             │
│ Target:                                                     │
│   Type   : app                                              │
│   ID     : app_42                                           │
│   Name   : 零售运营系统                                      │
│                                                             │
│ Action:                                                     │
│   Grant user 123 (editor) to app_42                         │
│                                                             │
│ Impact Analysis:                                            │
│   ┌─────────────┬─────────────────────────────────────┐   │
│   │  Risk Level │ LOW                                  │   │
│   │  Scope      │ Single app (app_42)                  │   │
│   │  Reversible │ YES (via revoke)                    │   │
│   └─────────────┴─────────────────────────────────────┘   │
│                                                             │
│ Prerequisites:                                              │
│   ✓ User 123 exists                                         │
│   ✓ Target app exists                                       │
│   ✓ No conflicting permission                               │
│                                                             │
├─────────────────────────────────────────────────────────────┤
│ Preview passed · ready for approval                         │
└─────────────────────────────────────────────────────────────┘
3.2.2 影响范围可视化
对于高风险操作(如数据删除、权限变更),Dry-Run会展示操作的影响范围:
┌──────────────────────────────────────────────────────────────────┐
│                    DRY-RUN IMPACT REPORT                         │
├──────────────────────────────────────────────────────────────────┤
│ Operation: dataset.delete                                         │
│                                                             │
│ Target:                                                     │
│   Dataset: "客户画像表" (ds_002)                                 │
│   App    : retail-ops                                          │
│                                                             │
│ Dependencies Analysis:                                        │
│   ┌────────────────────────────────────────────────────┐      │
│   │ 依赖此数据集的对象将受影响:                          │      │
│   │                                                     │      │
│   │   • 模型 "华东客户分析" (model_007)                 │      │
│   │     └─ 引用字段: [customer_id, tags, segment]      │      │
│   │                                                     │      │
│   │   • 仪表板 "客户洞察驾驶舱" (dash_023)             │      │
│   │     └─ 依赖模型 model_007                          │      │
│   │                                                     │      │
│   │   • 分享链接 3 个                                   │      │
│   └────────────────────────────────────────────────────┘      │
│                                                             │
│ Cascading Effects:                                            │
│   ┌────────────────────────────────────────────────────┐      │
│   │  [LOW] 级联删除风险                                  │      │
│   │                                                     │      │
│   │  若删除此数据集,系统将:                              │      │
│   │   1. 移除模型 model_007 中的对应字段                 │      │
│   │   2. 将仪表板 dash_023 标记为"数据源不可用"         │      │
│   │   3. 使分享链接指向空数据集                           │      │
│   │                                                     │      │
│   │  用户访问影响: 约 45 人                              │      │
│   └────────────────────────────────────────────────────┘      │
│                                                             │
├──────────────────────────────────────────────────────────────────┤
│ ⚠️  Dry-Run blocked: High-impact operation requires explicit   │
│    approval. Use --confirm to proceed or --cancel to abort.     │
└──────────────────────────────────────────────────────────────────┘
3.2.3 审批工作流集成
在团队协作场景中,Dry-Run可以与审批工作流集成:
# 提交Dry-Run结果到审批队列
$ everest authorize grant \
    --target-type app \
    --target-id app_42 \
    --user 123:editor \
    --dry-run \
    --submit-approval

# 输出
DRY-RUN APPROVAL REQUEST
═══════════════════════════════════════════════════

Request ID : apr_20260401_001
Submitter  : agent:claude-code-session-42
Timestamp  : 2026-04-01T15:30:00Z
Operation  : authorize.grant

Pending Approval From: [@admin-role]
Expected Resolution: 24h

Your operation has been queued for human approval.
Agent will be notified via SSE when decision is made.这种设计体现了AI与人类协作的治理理念:Agent可以在Dry-Run阶段探索和验证操作方案,最终由人类确认高风险操作的执行。
4. SSE回显机制
4.1 实时反馈的需求
当一个Agent发起一个可能耗时较长的操作(如数据导出、报表生成)时,它面临一个关键问题:如何知道操作进行到什么阶段了?是否遇到了错误?何时可以获取结果?
传统的轮询(polling)机制存在效率低下、响应延迟大的问题。SSE(Server-Sent Events) 为这一问题提供了优雅的解决方案:服务端主动推送操作进度和结果,Agent无需反复询问,只需监听一个持久连接即可。
4.2 HENGSHI CLI的SSE架构
┌────────────────────────────────────────────────────────────────────┐
│                        SSE Event Flow                               │
├────────────────────────────────────────────────────────────────────┤
│                                                                    │
│   Agent                         HENGSHI CLI                    BI  │
│     │                               │                            │  │
│     │  ┌─────────────────────┐      │                            │  │
│     │─▶│ 发起命令 (异步模式)   │──────▶│                            │  │
│     │  └─────────────────────┘      │                            │  │
│     │                               │  ┌──────────────────┐       │  │
│     │                               │─▶│ 建立SSE连接       │       │  │
│     │                               │  └────────┬─────────┘       │  │
│     │                               │           │                  │  │
│     │                               │           ▼                  │  │
│     │                               │  ┌──────────────────┐       │  │
│     │                               │─▶│ 转发事件到Agent   │──────▶│  │
│     │                               │  └──────────────────┘       │  │
│     │                               │                            │  │
│     │  ◀───────────────────────────────── event stream            │  │
│     │                               │                            │  │
│     │                               │                            │  │
│     ▼                               ▼                            ▼  │
│                                                                    │
└────────────────────────────────────────────────────────────────────┘
4.3 事件类型设计
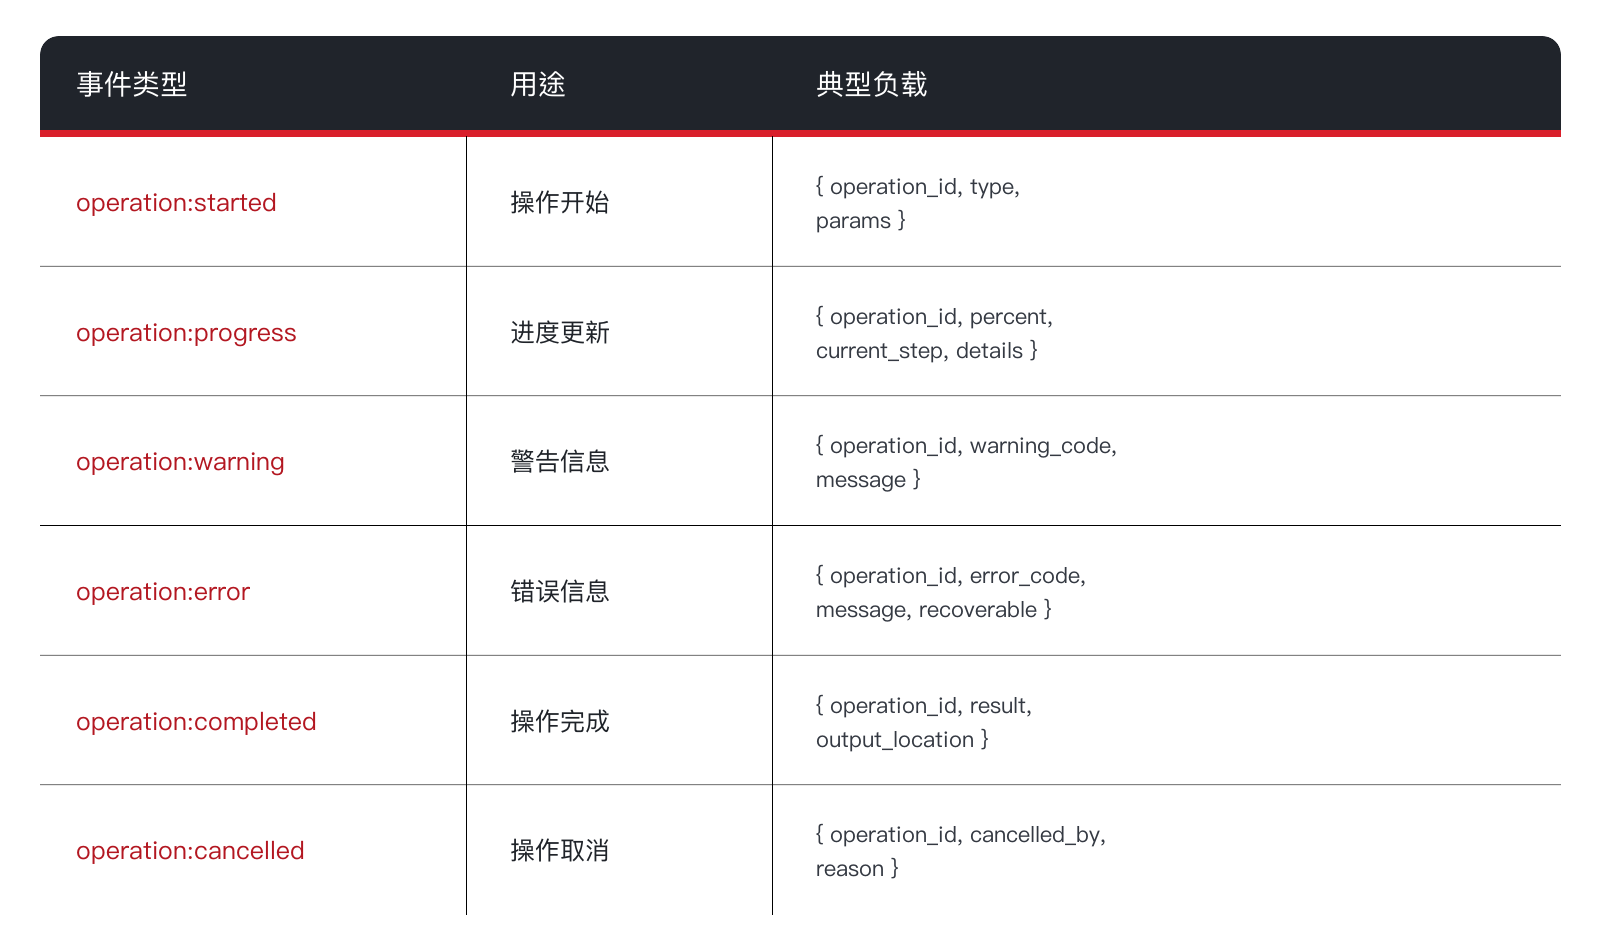
HENGSHI CLI的SSE通道定义了以下标准事件类型:
4.4 实际使用示例
# 启动SSE监听模式
$ everest dashboard create \
    --app retail-ops \
    "华东区域驾驶舱" \
    --async \
    --sse-url "http://localhost:9090/events/agent-42"

# 等待SSE事件...
event: operation:started
data: {"operation_id":"op_7a2f3c","type":"dashboard.create","timestamp":"2026-04-01T16:00:00Z"}

event: operation:progress
data: {"operation_id":"op_7a2f3c","percent":25,"current_step":"validating_app_access","details":"Checking access to retail-ops app"}

event: operation:progress
data: {"operation_id":"op_7a2f3c","percent":50,"current_step":"resolving_model","details":"Resolving default model for dashboard"}

event: operation:progress
data: {"operation_id":"op_7a2f3c","percent":75,"current_step":"creating_dashboard","details":"Creating dashboard resource"}

event: operation:completed
data: {"operation_id":"op_7a2f3c","result":{"dashboard_id":"dash_128","title":"华东区域驾驶舱","app":"retail-ops"},"output_location":"/results/op_7a2f3c.json"}
这种SSE回显机制的优势在于:
- 实时性:Agent可以在毫秒级别感知操作状态变化
- 可恢复性:即使Agent重启,只要记录了
operation_id,可以从上次已知状态继续监听 - 可调试性:完整的事件日志为问题排查提供了详细依据
- 可组合性:Agent可以同时监听多个操作的事件流
5. 工程实践
5.1 集成到Agent工作流
将HENGSHI CLI集成到Agent的工作流中,通常遵循以下模式:
┌─────────────────────────────────────────────────────────────────┐
│                    Agent Workflow with HENGSHI CLI              │
├─────────────────────────────────────────────────────────────────┤
│                                                                 │
│  ┌──────────┐    ┌──────────┐    ┌──────────┐    ┌──────────┐  │
│  │  理解任务  │───▶│  Dry-Run │───▶│  执行命令 │───▶│  处理结果 │  │
│  └──────────┘    └──────────┘    └──────────┘    └──────────┘  │
│       │                │               │               │       │
│       ▼                ▼               ▼               ▼       │
│  意图解析        验证方案安全性      SSE监听         结果存储   │
│  参数映射        影响范围评估       错误恢复         状态同步   │
│                                                                 │
└─────────────────────────────────────────────────────────────────┘
5.2 错误处理策略
HENGSHI CLI的错误处理遵循以下原则:
- 可预测的错误码:每个错误都有标准化的错误码,便于Agent理解和处理
- 可恢复的错误分类:区分临时性错误(如网络超时)和永久性错误(如参数无效)
- 建议性的错误信息:错误信息不仅说明发生了什么,还建议如何解决
# 错误示例
$ everest dashboard create --app invalid-app "测试仪表板"

# 输出
Error [E_APP_NOT_FOUND]: Application 'invalid-app' not found
├─ Suggestion: Use 'everest app list' to see available applications
├─ Did you mean: 'retail-ops' (similarity: 0.72)
└─ Error ID: err_20260401_a1b2c3
5.3 性能考量
在高频调用场景中,HENGSHI CLI提供了以下优化机制:
- 连接复用:保持与BI平台的持久连接,避免频繁握手
- 批量操作:支持将多个同类操作打包执行
- 缓存策略:对只读操作启用本地缓存,减少重复请求
# 批量查询示例
$ everest dataset batch-get \
    --ids ds_001,ds_002,ds_003 \
    --cache-ttl 300

# 输出
{
  "results": [...],
  "cache_hit": true,
  "cached_at": "2026-04-01T17:00:00Z"
}
6. 总结与展望
6.1 核心价值回顾
HENGSHI CLI作为Agentic BI三位一体架构的执行层,通过以下设计解决了AI Agent在BI场景中的核心挑战:
- Skills路由体系:将复杂的BI操作封装为语义清晰的技能模块,降低Agent的认知负担
- Dry-Run治理机制:在执行前提供完整的操作预览和影响分析,确保自动化行为的可预测性和可审计性
- SSE回显机制:为耗时操作提供实时反馈通道,使Agent能够准确感知执行状态
6.2 未来演进方向
随着AI Agent技术的持续演进,HENGSHI CLI的下一步发展可能包括:
- 自然语言接口增强:支持Agent用自然语言描述BI任务,CLI自动路由到最合适的命令组合
- 多模态响应:除文本外,支持返回图表、数据可视化等 richer 的结果形式
- 智能重试策略:基于历史执行数据,自动学习最佳的重试时机和参数调整策略
- 跨平台部署:支持在更多Agent运行环境中部署,包括云端、无服务器环境等
6.3 适用场景
资料与核验说明
内部资料用于梳理衡石能力与工程方法;竞品和版本信息按2026年8月26日可访问的官方页面复核。产品功能会受版本、地区、授权和部署模式影响,正式采购与发布前应再做一次现场确认。