Article body
正文
摘要: 企业让 AI 参与问数、指标探查与报表创作时,需要一套可复用的分析表达,把自然语言中的业务概念连接到明确的计算逻辑。衡石 HQL(Hengshi Query Language)承担指标定义、聚合计算与分析表达,指标语义层管理业务口径,Data Agent 组织分析过程,工具层完成具体操作。本文结合公式、HE 结构与协作示意,说明这些能力如何组成可验证的 AI 分析链路。
1 HQL 在分析链路中的位置
HQL 的价值在于把业务分析中的字段、聚合、计算、维度和过滤条件表达为可复用的公式。它可以出现在指标定义、图表分析和 API 所需的表达式中,并可由 HE(Hengshi Expression)这类结构化节点承载。这样,数据的存算位置与业务指标逻辑可以相对解耦:同一个“销售额”或“已完成订单金额”的定义,能被看板、报表、ChatBI 与后续的分析流程复用。
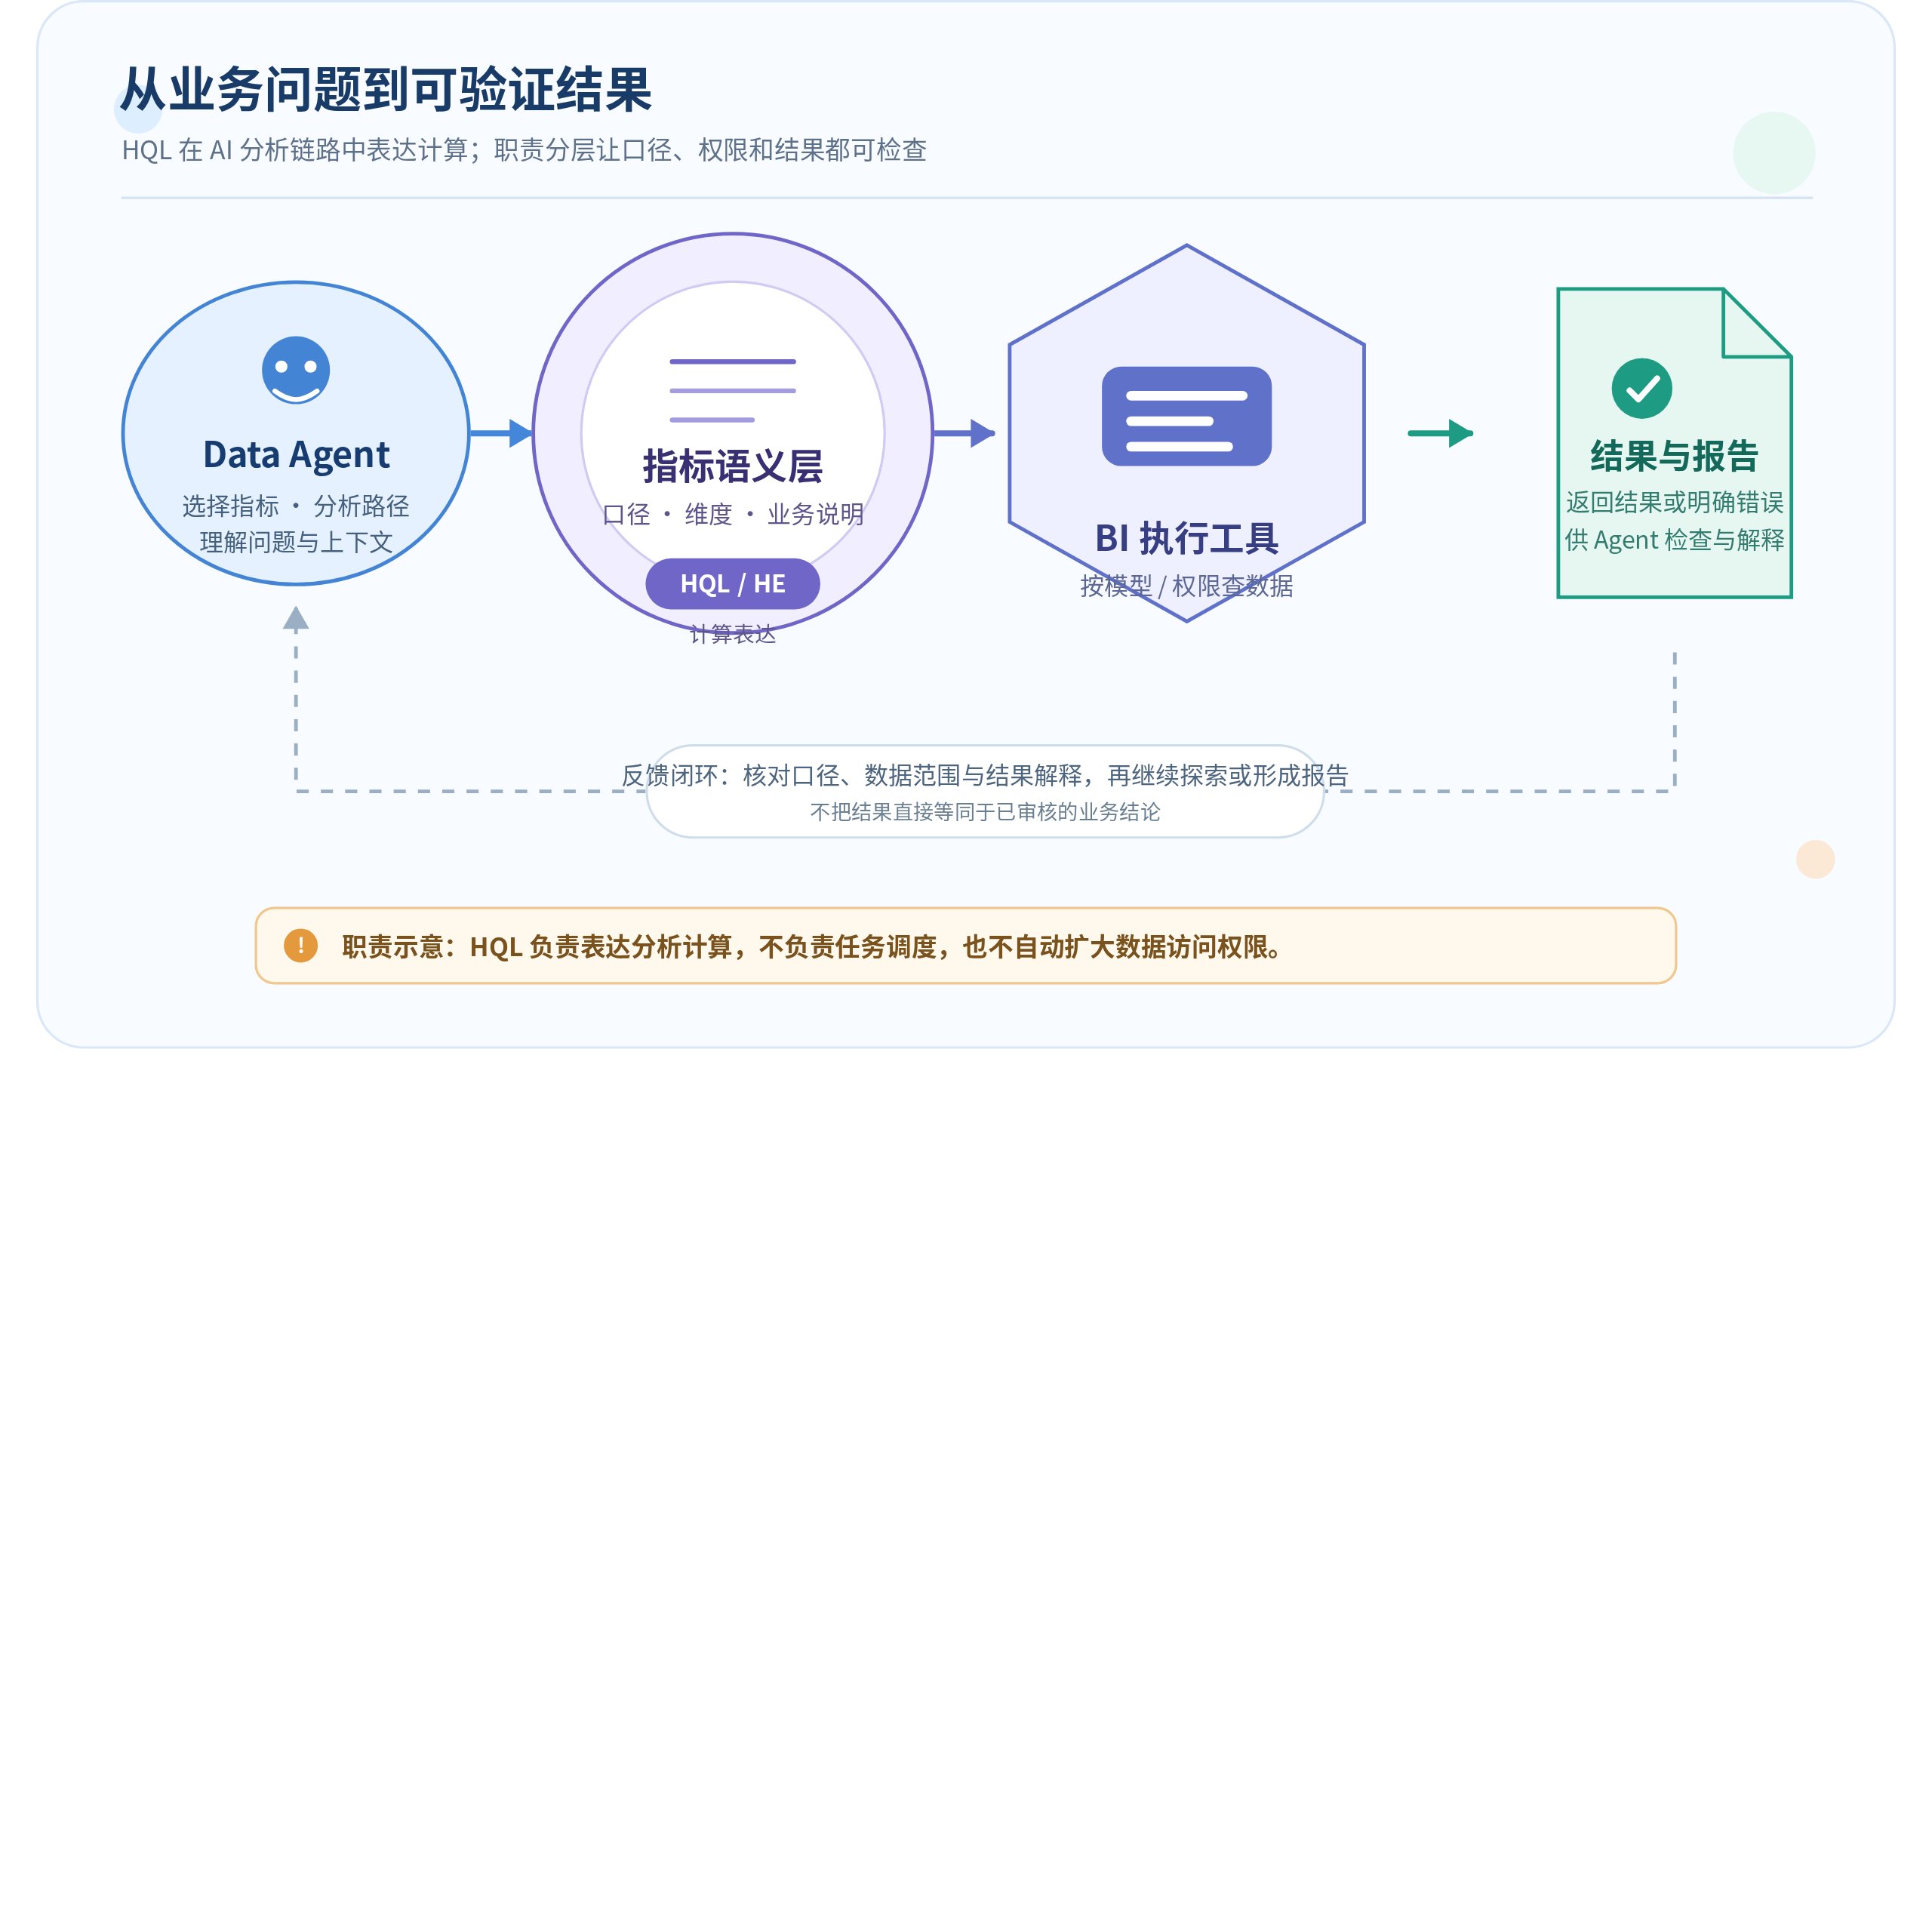
围绕同一个分析目标,各层需要保持清晰分工:HQL 表达计算,指标语义层维护口径,Agent 或工作流组织步骤,调度与运行系统管理执行周期、重试和资源。条件计算可以写进公式,任务分支、检查点和故障恢复则应由相应运行机制承担。这样可以分别验证公式是否正确、指标是否选对、任务是否执行成功,降低错误定位与后续维护的成本。
图1:HQL 在分析任务中的职责位置(能力分工示意,非内部服务拓扑)
| 层次 | 主要对象 | 在衡石分析链路中的作用 |
|---|---|---|
| HQL / HE | 字段、聚合、维度、过滤与计算公式 | 把分析口径表达为可保存、复用和校验的语义对象 |
| 指标语义层 | 业务指标、主题域、维度与口径说明 | 让不同看板、报表和问数入口对同一业务概念使用同一解释 |
| Data Agent / ChatBI | 意图、上下文、指标选择、解释与资产建议 | 把自然语言问题转为受语义层约束的分析动作,并向用户呈现结果 |
| HENGSHI CLI 与运行面 | 数据、查询、仪表板、权限及工程动作 | 为具备工具调用能力的 Agent 提供可执行、可审查的 BI 工程接口 |
衡石指标管理页面将这一思路概括为“一处定义,多方使用,口径归一”,并明确指出可通过 HQL 让数据存算与指标逻辑解耦。这里的“解耦”并不意味着脱离数据模型,而是让业务公式不必散落在每张图、每份报表或每次问答的临时文本中。
2 指标先于问答:用 HQL 沉淀可复用的口径
2.1 从一次查询到长期可用的指标定义
临时查询适合快速探索,但无法天然保证跨团队一致。若销售、财务和运营分别在各自图表中书写“销售额”,即使名称相同,也可能因状态过滤、退货处理、时间字段不同而得出不同结论。更稳妥的做法是把口径拆开管理:指标公式负责“怎么算”,维度负责“从哪个角度看”,过滤条件负责“在什么范围内成立”,并用名称、说明、主题域和责任人让使用者理解它。
下面仅展示 HQL 聚合和维度表达的写法,字段名均为演示字段,不对应任何客户数据或预置模型。生产定义还应结合实际数据集、字段类型、时间口径和权限范围验证。
sum({amount})

sum(case when {order_status} = 'completed' then {amount} else 0 end)

group({region})
第一行可作为金额类指标的聚合基础;第二行表达“仅统计已完成订单”的条件口径;第三行将区域作为分组维度。它们本身不等同于一份业务报表,真正可复用的指标还需要补足名称、适用数据集、默认筛选、精度和业务解释。对涉及跨数据集、窗口计算或复杂过滤的公式,更应由数据与业务负责人共同评审,而不是让自然语言一次性生成后直接发布。
2.2 HE 让表达式可以结构化传递
HQL 可被 HE 节点结构化表示。结构化表示的意义不在于替代人读公式,而在于让图表、接口和工具调用能够带着明确的类型、数据集与表达式传递同一个计算意图。以下 JSON 仅说明公式节点的形态,数据集编号与字段均为演示值:
{
  "kind": "formula",
  "op": "sum({{1}}.{amount})"
}在这个例子中,formula 表明节点承载一段公式,op 保存表达式文本;{{1}}.{amount} 用数据集限定的字段引用来减少歧义。实际接口还可能使用 field、function、constant、reference、param 等节点类型,并由调用方补充所需上下文。开发时应以 HQL 参考文档和当前版本 API 契约为准,而不要凭记忆拼接 JSON。
3 NL2Metrics:让自然语言先落到已定义的业务概念
企业级自然语言分析的关键不是“把一句话翻成一条查询”,而是先判断这句话指向哪个业务概念。用户问“本月华东已完成订单金额与上月相比怎样”,系统需要依次识别指标候选、时间范围、区域维度和比较方式;其中“已完成订单金额”应优先指向已经治理过的指标,而不是临时生成一段看似合理、实则可能改变口径的公式。
衡石 AI 分析智能体页面将这一架构描述为以 NL2Metrics 和建模语义层为核心;Data Agent 产品手册还说明,它可进行意图拆解和多次查询,并在用户权限范围内结合当前页面与用户属性等上下文检索。这意味着自然语言入口可以更贴近业务,但仍必须以权限、语义资产和上下文为约束。
一条更可靠的链路可以写成:业务问题 → 指标与维度解析 → HQL / HE 表达式 → 受权限约束的数据查询 → 结果解释与追问。模型在其中承担理解、候选选择和解释的工作,指标语义层承担“可用概念的边界”,HQL 承担“计算如何表达”。这也解释了为什么知识管理中的业务规则、同义词和预置指标很重要:它们为模型提供可引用的企业语境,而不是把所有判断交给一次生成。
需要保持一个现实预期:生成式模型对相同输入不保证每次给出完全相同的文本或推理路径。对关键经营口径,应在结果中展示或可追溯到指标定义、筛选范围和数据时间;对新建指标、创建仪表板等资产动作,应设置复核和发布边界,而不以一次对话代替治理流程。
4 Data Agent 与 CLI:把“理解分析”与“执行工程”分开
Data Agent 的适用面是分析协作:理解问题、调用已治理的指标与数据上下文、辅助建模或报表创作、解释异常与组织后续探索。它不应绕过语义层直接把每个请求变成无约束查询,更不应自行扩大数据权限。对于需要落到 BI 工程的动作,例如读取数据集信息、执行查询、生成仪表板或处理权限相关操作,HENGSHI CLI 提供面向 Agent 的命令行执行面,并提供结构化输出、skills、dry-run 和 SSE 回显等工程机制。
| 问题 | 优先承载层 | 应保留的控制点 |
|---|---|---|
| “这个指标怎么算、能否按区域看?” | 指标语义层与 HQL | 指标说明、公式、维度与默认过滤可追溯 |
| “这份报表反映了什么、下一步查什么?” | Data Agent / ChatBI | 用户权限、当前上下文、引用的指标与数据范围 |
| “把经过审查的方案生成分析资产” | CLI 与工程工作流 | 命令帮助校验、dry-run、变更审查与结果回显 |
| “每天何时跑、失败后如何重试?” | 调度与运行系统 | 调度策略、告警、重试和资源治理由运行面负责 |
这种分工不是增加层次,而是减少错误外溢。Data Agent 先提出或验证分析意图,HQL 把可复用的计算落实为表达式,CLI 在需要时执行明确的工程动作,调度系统处理长期运行的任务。具体命令、参数和可用资源会随版本和部署而变化,自动化脚本应先读取当前 CLI 帮助与团队 runbook,再执行任何会改变资产或权限的操作。
5 落地方法:把可验证性放在自动化之前
第一,盘点高频且争议多的经营指标,优先把公式、维度、数据集和业务说明沉淀下来;不要试图一次覆盖全部指标。第二,为自然语言问题建立同义词、业务规则和示例问法,使“成交额”“销售额”“GMV”等近义或有差异的概念能被正确区分。第三,对 HQL 和 HE 先做语法、字段和权限校验,再进入查询或图表生成。第四,把数据范围、口径版本和结果解释一并返回,让业务人员能够判断答案是否回答了原问题。第五,对创建、授权、发布和定时运行等变更动作使用独立的工程控制,使任务控制与分析公式分别可检查。
HQL 在 Data Agent 时代的意义,是提供一个稳定的分析表达锚点:既让指标定义能够复用,也让自然语言和工具调用能落到可验证的计算语义上。把它与语义层、NL2Metrics、Data Agent 和 CLI 各自的职责分清,企业才能在提升分析效率的同时,保留口径一致性、权限边界和工程可维护性。