
Article body
正文
ChatBI让用户用自然语言访问数据,Agentic BI则接管一段完整的分析任务。两者的边界可以用一个销售场景判断。用户问“华东区本月收入是多少”,系统返回数字,属于对话式分析;用户给出“找出收入下滑原因,生成复盘材料,并把重点客户名单交给销售团队”,系统需要规划、分析、生成产物和发起动作,这才进入Agentic BI。
分析智能体负责证据链
分析智能体接收业务目标后,先建立问题树。收入下降可能来自客户数、客单价、产品结构或退款变化。系统逐项读取指标定义、调用查询工具并比较结果,再根据中间证据调整后续路径。这个过程需要保留每一步使用的指标、筛选条件和数据来源,否则业务人员无法复核结论。
好的分析智能体也会管理不确定性。数据不足时,它应提出缺口,给出可验证假设;多个指标口径冲突时,它应暂停并请求确认。企业需要可解释的分析过程,不能只接收一段语气笃定的文字。
操作智能体连接业务系统
操作智能体把结论转换成可执行任务。它可以创建仪表盘、更新订阅、生成客户清单,或调用CRM、工单和通知系统。每类动作都需要明确的参数、权限和状态回传。系统还要处理超时、部分失败和重复调用,避免一次重试创建两份任务。
高风险动作应引入Dry Run。Agent先展示将要修改的对象、影响范围和预期结果,用户确认后再执行。写入完成后,操作智能体把结果回传给分析智能体,后者继续观察指标变化。这样才能形成分析、决策、行动和反馈的闭环。
双引擎共享三类状态
协同需要一套共同状态。第一类是业务状态,包括目标、约束和成功标准;第二类是分析状态,包括已验证的假设、查询结果和置信度;第三类是执行状态,包括审批、进度、错误与回滚点。缺少其中任何一类,系统都容易在长任务中丢失上下文。
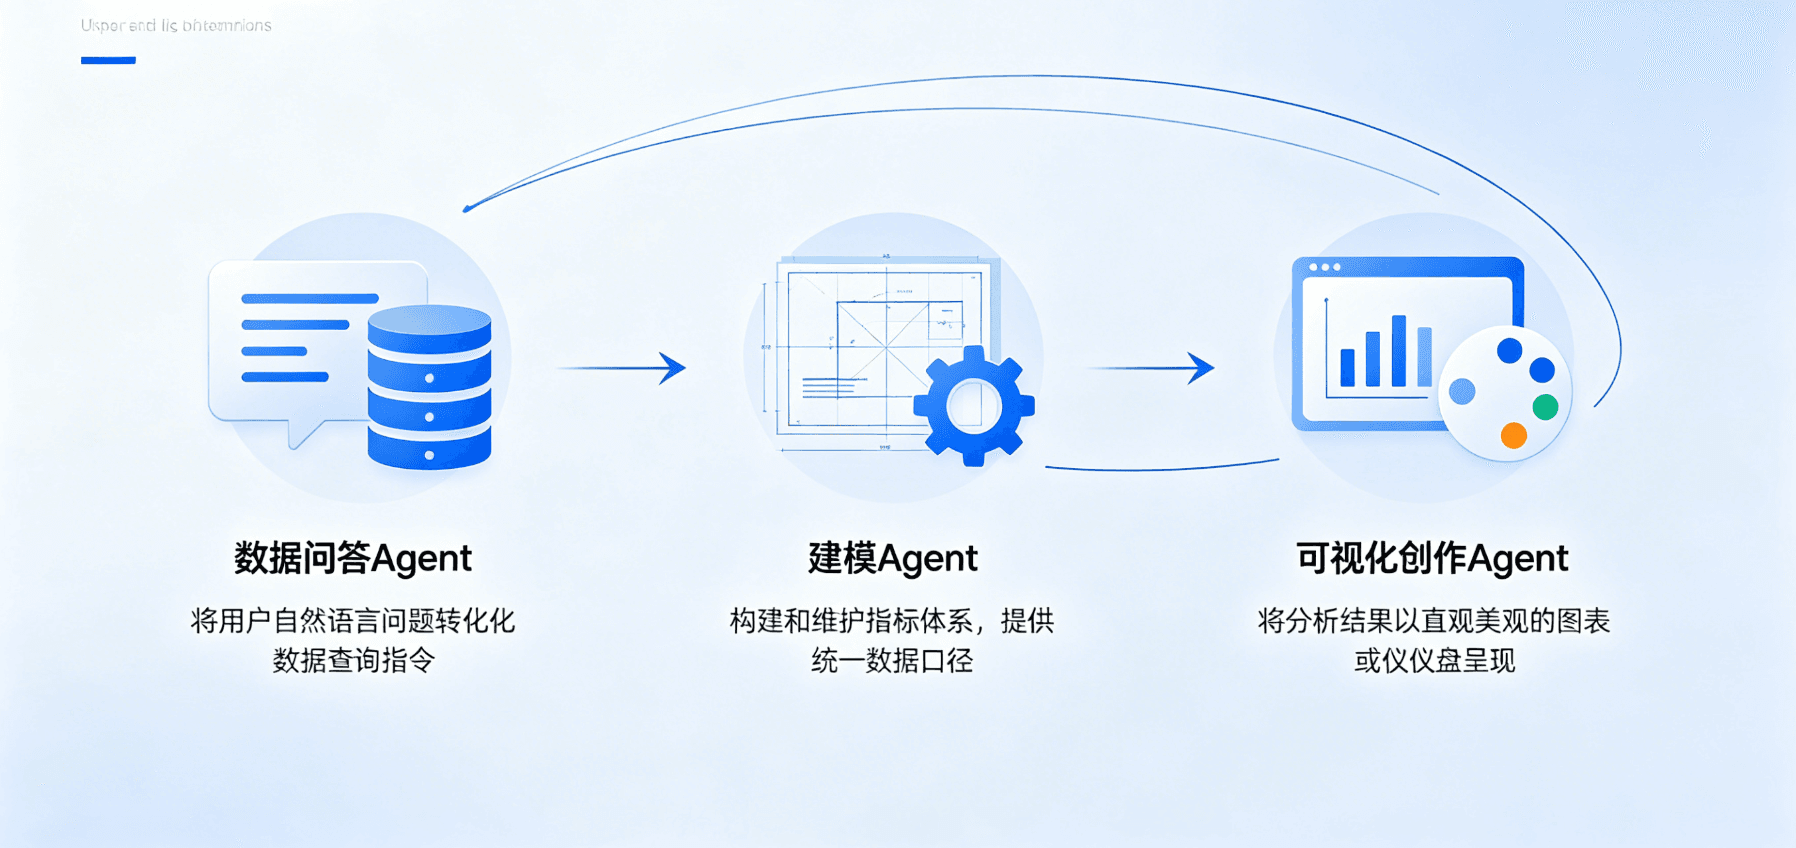
多智能体架构还需要清晰的责任边界。建模Agent维护数据关系,问数Agent解释指标,创作Agent生成可视化,操作Agent处理外部动作。调度器负责依赖和重试,语义层提供统一业务语言,权限系统决定每个工具能做什么。团队可以替换其中一个模型或工具,不必重写整条链路。
企业采购要看完成率
演示现场的一次成功问答很难说明Agentic能力。采购测试应使用十到二十条真实任务,记录任务完成率、人工介入次数、错误可恢复性、口径一致性和审计完整度。平台若只能生成建议,仍处在分析助手阶段;平台若能在授权范围内稳定交付资源与动作,才具备Agentic BI的工程基础。
工程细节与实施补充
一、ChatBI的工程困境:为什么”自然语言查数据”不够用
1.1 ChatBI的核心技术路线
在分析Agentic BI之前,我们需要先理解ChatBI的技术路线及其局限。
ChatBI的典型技术实现链路如下:
用户自然语言 → LLM意图解析 → Text-to-SQL → 数据库查询 → 结果格式化 → 自然语言回复这条链路在”单表查询”场景下工作良好:例如”上个月销售额是多少”、“华东区有多少客户”这类简单问题。但当查询需求变得复杂时,这条链路的每一个环节都可能出问题。
1.2 ChatBI的五大工程困境
困境一:上下文爆炸
企业级数仓通常包含数百张表、数千个字段、复杂的星型/雪花模型和多层嵌套的维度关系。即使用目前最大的上下文窗口,也不可能将完整的数仓schema全量输入给LLM。
常见的”优化”方案(如只输入相关表的schema)又引入了新问题:LLM需要先判断”哪些表是相关的”,而判断本身就需要对数仓结构有准确理解:这是一个”鸡生蛋”的循环依赖。
困境二:语义鸿沟
业务用户的语言和数据库的语言之间存在巨大的语义鸿沟:
- 用户说”收入”→ 数据库可能是revenue_amount、gross_sales、net_revenue等多个字段
- 用户说”华东区”→ 数据库可能是region_id IN (‘SH’, ‘JS’, ‘ZJ’)的硬编码映射
- 用户说”同比”→ 数据库可能需要复杂的窗口函数或自连接查询
Text-to-SQL需要准确地将业务语言映射为数据库语言,但在没有精准语义层的情况下,这种映射的准确率很难达到企业级要求。
困境三:幻觉与确定性查询的矛盾
大语言模型的本质是概率生成模型:它生成的是”最可能的回答”,而不是”确定正确的答案”。但企业级数据分析要求的是确定性的查询结果:同样的查询必须返回完全相同的数据。
当LLM生成的SQL包含错误(写错了字段名、用错了JOIN条件、遗漏了过滤条件),结果可能是完全错误的,而且这种错误往往不容易被发现:因为LLM还会为错误的结果生成”看起来合理”的解释。
困境四:长流程任务的断裂
真实的企业分析需求很少是”一步到位”的。一个典型的分析流程可能是:
- 找到相关数据源
- 理解数据结构和业务含义
- 构建数据模型(多表关联、字段计算)
- 定义分析指标
- 创建可视化
- 交互式探索(筛选、钻取、对比)
- 分享和协作
ChatBI只能处理其中的第6步(而且只是简单的查询),而无法覆盖完整的分析流程。
困境五:企业级能力的缺失
权限管控:“我是华东区的销售经理,我只能看到华东区的数据” 数据安全:“客户手机号需要脱敏展示” 审计追溯:“谁在什么时候修改了哪个报表” 指标统一:“财务部和销售部对’收入’的定义必须一致”
这些企业级能力是BI平台经过多年积累形成的核心竞争力,而ChatBI几乎完全不具备。
1.3 ChatBI vs Agentic BI的本质区别
| 对比维度 | ChatBI | Agentic BI |
|---|---|---|
| 技术定位 | 自然语言查询接口 | 全栈分析智能体 |
| 覆盖范围 | 单一查询环节 | 完整分析工作流 |
| 核心技术 | LLM + Text-to-SQL | Agent + 语义层 + API |
| 数据建模 | 无法处理 | Agent可自主完成 |
| 指标定义 | 依赖预设 | Agent可创建和管理 |
| 可视化 | 简单表格/图表 | 完整仪表盘创作 |
| 错误处理 | 无法自愈 | 自动重试与学习 |
| 幻觉控制 | 依赖prompt工程 | 语义层从根本上消除 |
| 企业级能力 | 基本缺失 | 完整支持 |
二、Agentic BI的架构设计:三层解耦与Agent编排
2.1 核心架构:Headless + CLI + Agent 三位一体
衡石科技的Agentic BI架构可以抽象为三层:
为什么需要三层解耦?
Agent层的独立性:Agent层负责理解用户意图和编排任务流程,但它不应该直接操作数据库或渲染图表。Agent通过CLI调用Headless层的能力,保持关注点分离。这意味着Agent可以被替换(例如用不同的LLM或Agent框架),而不影响底层引擎。
CLI层的标准化:CLI(Command Line Interface)不是传统意义上的命令行工具,而是一个程序化的标准化接口层。它将Headless层的所有能力封装为标准化的命令/操作,任何Agent(无论是衡石自家的Data Agent,还是第三方的OpenClaw等)都可以通过CLI调用这些能力。
Headless层的稳定性:Headless层是整个架构的”确定性”根基。无论上层的Agent如何”不确定”(LLM的随机性),Headless层的查询结果、权限校验、指标计算都必须是100%确定性的。这种”确定性的底层 + 智能化的上层”的组合,是Agentic BI区别于纯ChatBI的关键。
2.2 Task Planner:多Agent编排的技术实现
Task Planner是Agentic BI架构中”最不像BI”但最重要的组件。它是一个任务分解与编排引擎,负责将用户的自然语言请求拆解为可执行的子任务序列。
技术实现的关键挑战:
任务分解的准确性: 当用户说”帮我分析一下上季度的销售情况”时,这是一个极其模糊的请求。Task Planner需要:
- 识别分析范围(上季度 = 日期范围筛选)
- 推断分析维度(销售情况可能涉及金额、数量、区域、产品等多个维度)
- 确定展示形式(仪表盘、表格、图表)
- 考虑用户偏好(用户之前是否做过类似分析?偏好什么图表类型?)
任务依赖的管理: 如果任务序列是”先创建数据集 → 基于数据集创建仪表盘 → 在仪表盘上添加图表”,那么”创建仪表盘”依赖”创建数据集”的结果(数据集ID),“添加图表”依赖”创建仪表盘”的结果(仪表盘ID)。Task Planner需要正确管理这些依赖关系,确保执行顺序的正确性。
错误恢复与重试: 当某个子任务执行失败时(例如创建数据集时SQL语法错误),Task Planner需要:
- 捕获错误信息
- 分析错误原因
- 尝试自动修正(例如修正SQL语法)
- 重试执行
- 如果重试仍然失败,向用户报告并提供修正建议
2.3 语义层:消除幻觉的技术根基
在Agentic BI的架构中,语义层(Semantic Layer)是消除AI幻觉的技术根基。
语义层的核心作用:
语义层在数据库和Agent之间构建了一层”业务语义翻译器”:
业务语言                    语义层                    数据库语言
─────────                ─────────                ──────────
"上季度收入"    →    指标: revenue_q    →    SELECT SUM(amount)
                        定义: SUM(order.amount)        FROM orders
                        筛选: order_date >= Q_START    WHERE order_date >= ?
                        粒度: 月                        AND order_date <= ?
语义层消除幻觉的三种机制:
- 边界约束:语义层定义了所有可用字段、指标和维度的”白名单”。Agent只能从白名单中选择,无法”编造”不存在的字段或指标。这从根本上消除了”幻觉字段”和”幻觉指标”的问题。
- 类型安全:语义层为每个字段和指标定义了精确的数据类型、度量方式(SUM/AVG/COUNT等)和维度关系。Agent生成的查询请求必须通过语义层的类型校验,确保查询的合法性。
- 统一口径:语义层中的指标定义是唯一的、权威的。无论Agent在哪个上下文中引用”收入”这个指标,都会得到完全相同的定义和计算结果,消除了”同义词歧义”和”多口径矛盾”。
三、HENGSHI CLI:Agent与平台之间的标准化桥梁
3.1 CLI的设计理念
2026年4月1日,衡石科技推出了HENGSHI CLI。这个工具的推出时机(在6.2版本发布前15天)并非偶然:它是Agentic BI架构的关键前置组件。
HENGSHI CLI的设计理念是:让平台的所有能力都可以被程序化调用,而不仅仅是通过GUI操作。
传统BI平台的能力是”GUI-First”的:用户通过点击按钮、拖拽组件来使用功能。如果要让AI Agent调用这些能力,要么模拟GUI操作(脆弱且不可靠),要么在GUI之上再建一层API(额外维护成本)。
HENGSHI CLI的方案是:直接在平台核心上暴露标准化的命令接口,与GUI并列,而不是在GUI之上封装。 这意味着CLI和GUI是平级的调用方式,都直接操作同一套底层引擎。
3.2 CLI的核心能力
HENGSHI CLI提供了以下核心命令类别:
| 命令类别 | 功能描述 | 典型用例 |
|---|---|---|
| 数据连接 | 管理数据源连接 | 创建、测试、更新数据库连接 |
| 数据集 | CRUD数据集 | 创建数据集、配置关联关系、预览数据 |
| 语义模型 | 管理语义层 | 定义指标、配置维度关系、管理口径 |
| 仪表盘 | CRUD仪表盘 | 创建仪表盘、添加图表、配置布局 |
| 权限 | 管理权限 | 配置角色、授权数据访问、审计日志 |
| 导出 | 数据导出 | 导出CSV/Excel、定时导出任务 |
| 管道 | 数据管道 | 配置ETL流程、监控管道状态 |
3.3 CLI的生态意义
HENGSHI CLI的推出有一个重要的生态意义:它让衡石的平台能力可以被任何AI Agent调用,而不局限于自家的Data Agent。
通过CLI,第三方Agent框架(如OpenClaw、AutoGen、LangGraph等)可以:
- 通过CLI连接到衡石的平台
- 调用衡石的BI能力(数据建模、指标计算、可视化等)
- 将衡石的BI能力整合到更大的Agent工作流中
这意味着衡石科技不再是一个封闭的”BI平台”,而是一个开放的”BI能力供应商”:任何AI Agent都可以通过标准化的CLI接口获取衡石的BI能力。
四、Agentic BI的核心工程特性
4.1 自适应纠正:从错误中自动恢复
Agentic BI最令人印象深刻的技术特性之一是自适应恢复。衡石科技的Agent可以根据数据库报错自动重试与纠正,直接接管繁重的数据工程工作。
自愈流程的技术实现:
典型的自愈场景:
- 场景1:Agent生成的SQL引用了一个已经被重命名的字段。数据库报错”column not found”。Agent解析错误信息,在语义层中搜索相似的字段名,自动替换后重试。
- 场景2:数据源的结构发生了变化(新增了列、修改了数据类型)。Agent检测到schema变更,自动更新数据集的元数据和关联关系。
- 场景3:一个复杂的查询超时了。Agent自动将查询拆分为多个子查询、添加索引建议或调整聚合粒度后重试。
4.2 持续学习:从用户行为中进化
Agentic BI 的另一个关键技术特性是持续学习。Agent 可以从用户的操作、反馈和偏好中持续学习,不断优化自身的分析能力。
学习机制的三个层次:
- 即时适应:在一次对话中,Agent记住用户之前的指令和修正,后续的交互自动应用这些上下文。例如用户说”不要用柱状图,用折线图”,Agent在后续的图表创建中会自动使用折线图。
- 跨会话记忆:Agent记录用户的长期分析偏好:常用的维度、偏好的图表类型、常用的筛选条件等。在新的会话中,Agent会自动应用这些偏好。
- 组织级学习:在多人使用的环境中,Agent可以从整个组织的分析模式中学习。例如,如果大部分用户在分析销售数据时都会按区域和产品维度分组,Agent在面对新的销售分析请求时会自动建议这两个维度。
4.3 端到端自动化:全链路覆盖
Agentic BI的核心承诺是端到端自动化:从数据接入到可视化展示的完整分析流程,都可以由Agent驱动完成。
端到端流程的技术实现:
┌─────────┐   ┌─────────┐   ┌─────────┐   ┌─────────┐
│ 数据接入  │ → │ 语义建模  │ → │ 指标定义  │ → │ 可视化    │
│ Connect │   │ Model   │   │ Metric  │   │ Visual  │
└─────────┘   └─────────┘   └─────────┘   └─────────┘
      │             │             │             │
  Agent可       Agent可        Agent可        Agent可
  自动配置       自动构建       自动创建       自动生成
  数据连接       JOIN关系       计算指标       仪表盘
这个流程中,每一个环节都由Agent通过CLI调用Headless层的API完成,确保了全链路的自动化和确定性。
五、总结:Agentic BI是数据分析的必然方向
回到文章开头的问题:Agentic BI为什么代表了数据分析领域的下一个架构演进?
因为ChatBI解决的是”最后一公里”的问题:如何让用户更方便地查询数据。而Agentic BI解决的是”全程”的问题:如何让AI Agent接管整个数据分析工作流,从数据建模到可视化展示,从指标定义到权限管控。
ChatBI是一个”查询工具”,Agentic BI是一个”分析平台”。ChatBI让用户少写SQL,Agentic BI让用户少做一切:除了”提出想法”。
衡石科技的HENGSHI SENSE 6.2已经证明了Agentic BI的技术可行性。Headless架构提供了确定性的根基,CLI提供了标准化的接口,Data Agent提供了智能化的交互。三位一体,构成了Agentic BI的完整技术栈。
但这只是开始。随着AI能力的持续提升和Agent框架的成熟,Agentic BI将在以下方向继续进化:
- 更复杂的分析推理:Agent不仅能执行明确的指令,还能主动发现数据中的异常、趋势和机会
- 多Agent协作:不同领域的Agent(数据Agent、业务Agent、安全Agent)协同完成复杂的分析任务
- 自适应学习:Agent能够从组织的整体分析模式中学习,提供越来越精准的分析建议
- 跨平台集成:通过标准化的CLI和API,Agentic BI能力可以嵌入到任何企业应用中
资料与核验说明
内部资料用于梳理衡石能力与工程方法;竞品和版本信息按2026年8月26日可访问的官方页面复核。产品功能会受版本、地区、授权和部署模式影响,正式采购与发布前应再做一次现场确认。