Article body
正文
**摘要:**高频经营看板经常重复计算同一批订单、产品和组织维度。团队可以把稳定、可复用的计算提前准备,却不能只看查询速度:分析粒度、数据时效、指标口径和修正路径都要在方案里写清楚。HENGSHI SENSE 提供聚合数据集、加速引擎、数据更新和多表联合等产品能力;ClickHouse 增量物化视图则是一种由源表插入触发的底层结果维护机制。下面以制造订单为例,说明如何把高频查询的粒度、结果维护和指标复用一起设计。
1 先把重复查询拆成两个问题
制造企业的经营看板需要按日、工厂、产品线查看订单金额、交付数量和完成率。订单事实表持续写入,产品维表保存产品线和型号,组织维表保存工厂与区域。业务人员会在同一组维度上反复筛选、汇总和下钻。团队面对的并非单一的“慢查询”,而是两个独立问题:看板要服务哪些固定分析粒度;当新订单或维表发生变化时,已经准备好的结果由哪条链路维护。
前一个问题属于模型与分析设计。后一个问题属于数据同步与结果维护。把它们分开后,团队能先用聚合数据集沉淀日、工厂、产品线等稳定粒度,再根据数据进入分析侧的方式选择更新计划、即时更新或已验证的数据库维护方案。查询是否受益要用真实数据规模、筛选条件、并发和新鲜度目标测试,不能用固定行数、响应时间或倍数替代验收。
2 用聚合数据集定义可复用的分析粒度
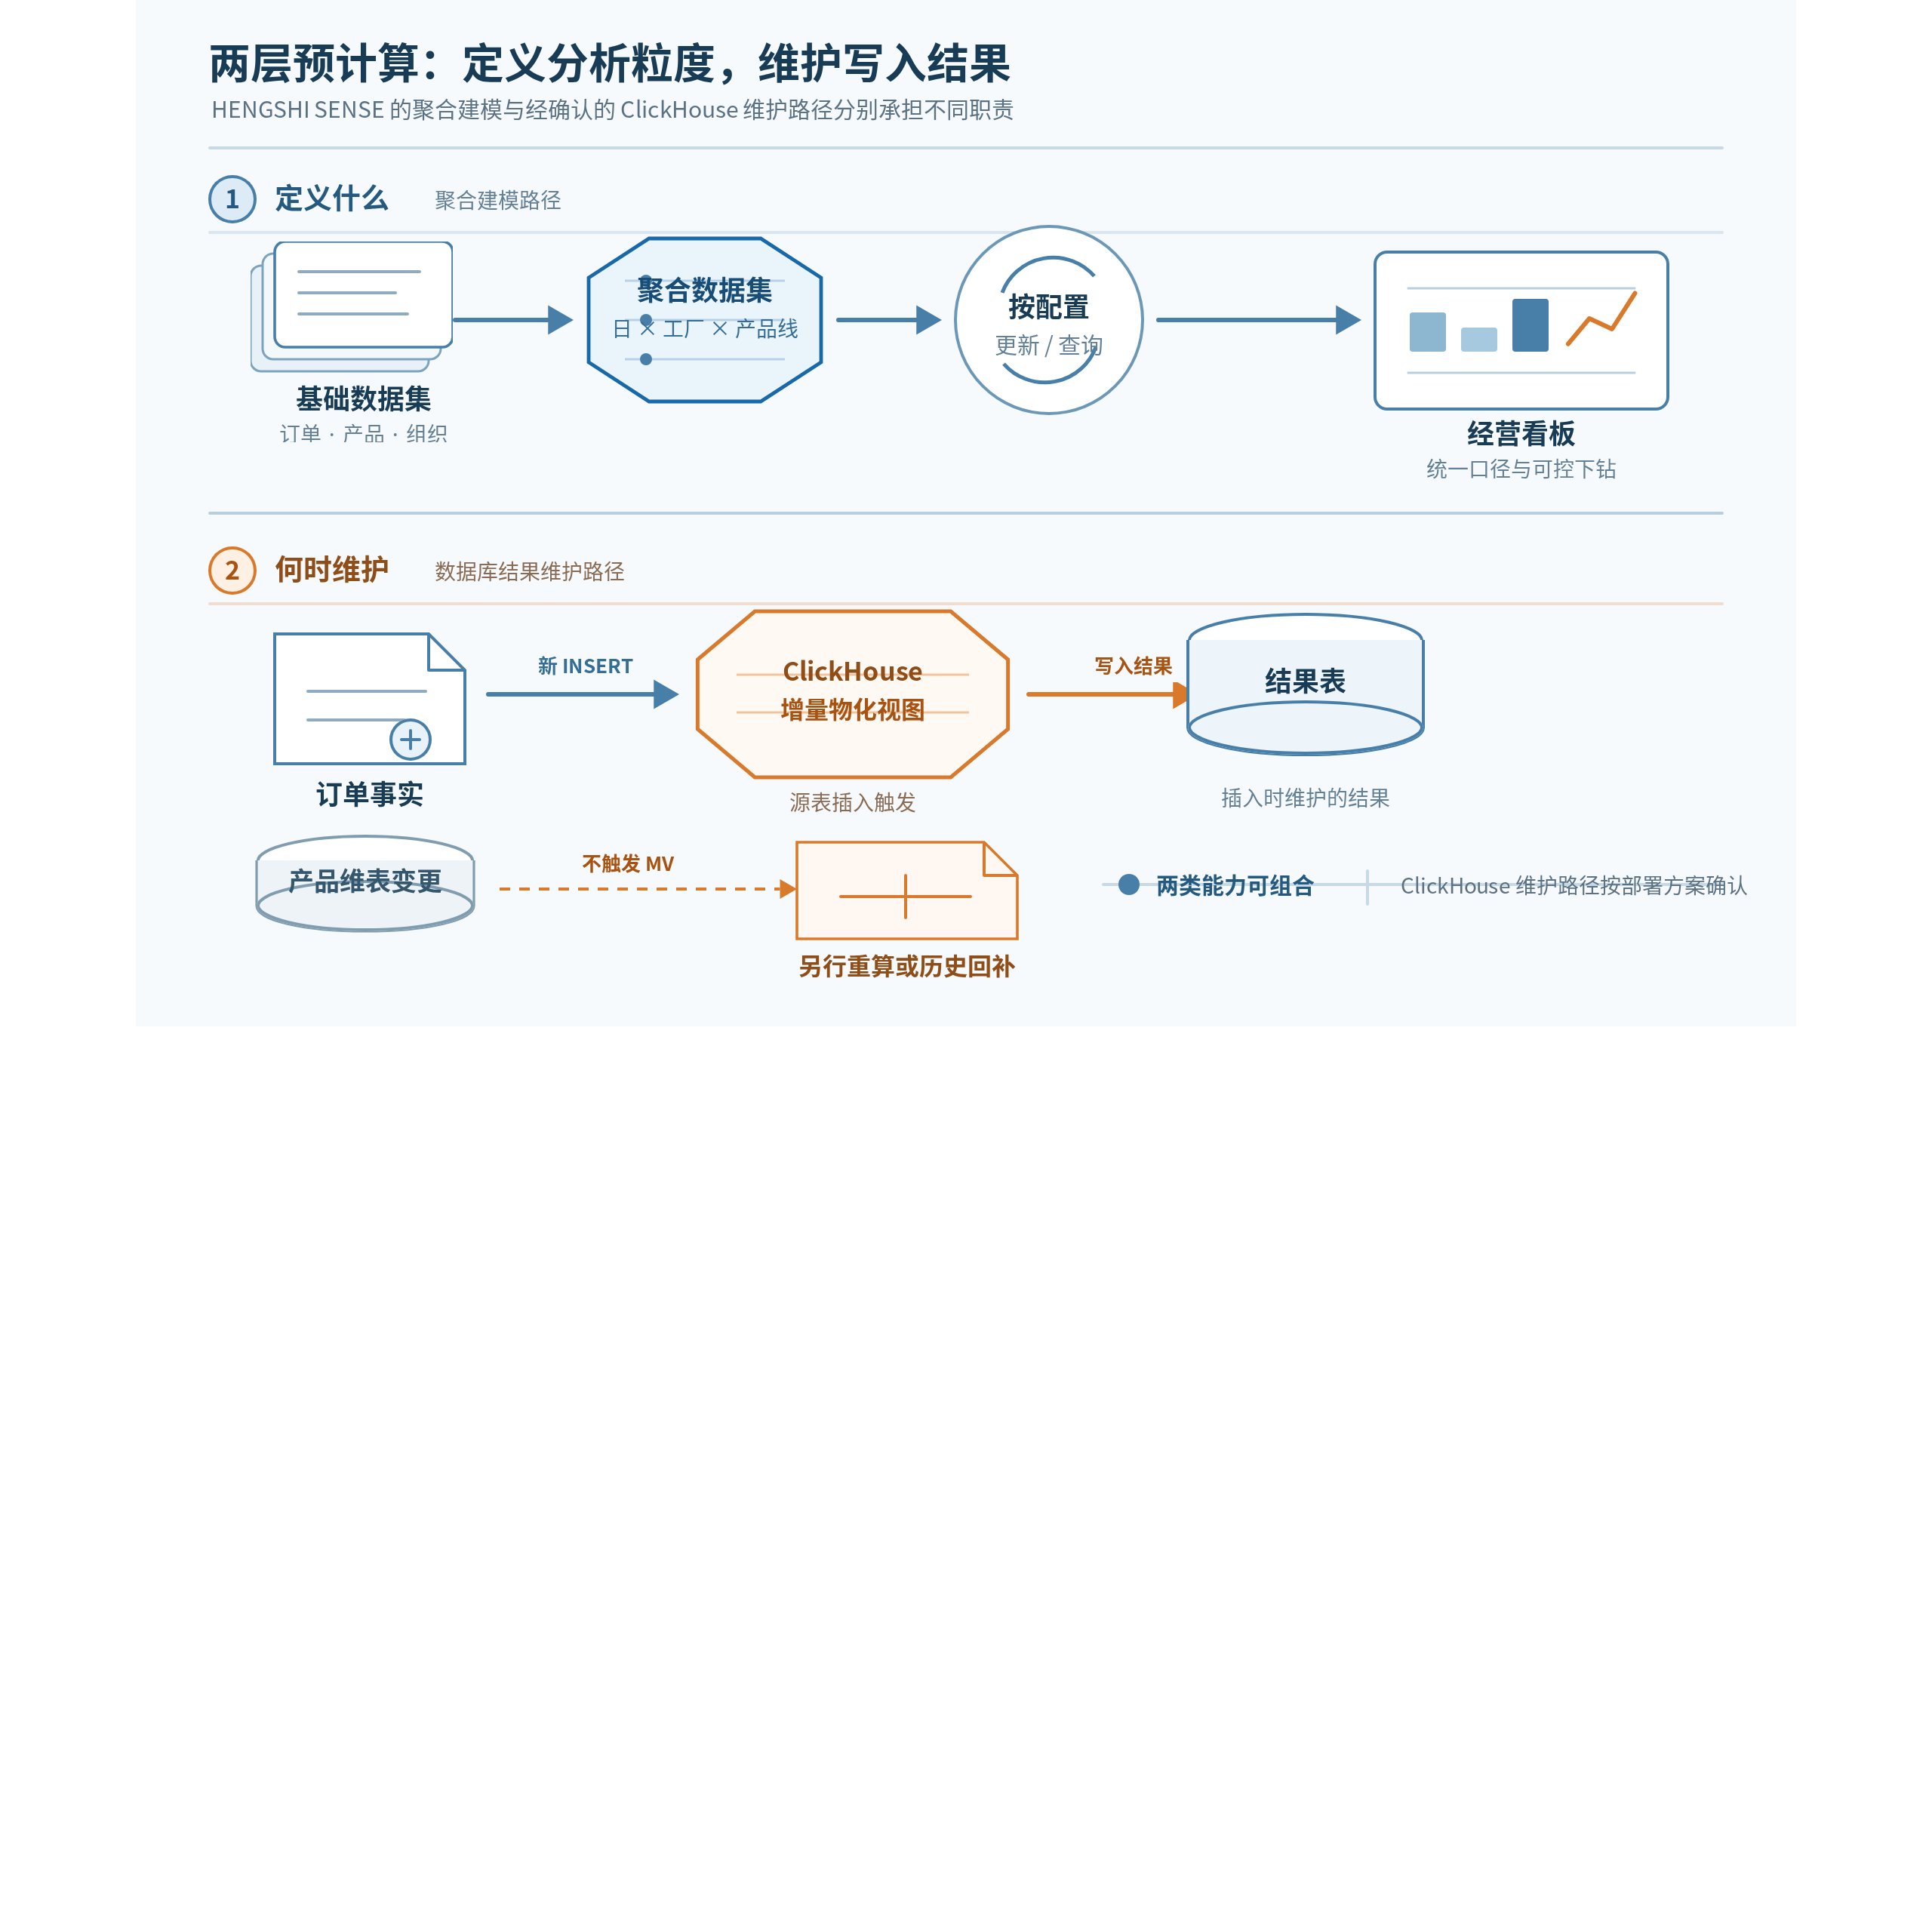
衡石将聚合数据集定义为对已有数据集做预先聚合计算,把大表收敛为供分析使用的小表。创建时,建模人员选择基础数据集,放入维度、度量和过滤条件;维度可放字段,度量可放字段或指标,过滤器也支持字段、指标和图内指标。这个界面把“哪些维度要保留、哪些指标要复用、哪些范围需要限定”放到可维护的分析对象中。
在订单示例中,团队可以先保留订单号、下单时间、工厂、产品、金额和数量的明细数据集,再建立“日 × 工厂 × 产品线”的聚合数据集。产品经理若需要按型号查看波动,就把型号纳入聚合粒度;若只需产品线经营总览,就让型号留在明细数据集中。聚合结果能否下钻,取决于结果中保留的维度。缺少型号时,聚合数据集不能独自回答型号明细;团队仍可从保留的明细数据集继续分析。这样既避免把所有查询压到明细表,也不把预聚合理解成删除原始粒度。
多表关系也应先在数据模型中核对。HENGSHI SENSE 的多表联合数据集支持按字段建立左、右、内、外连接,并要求在预览数据中确认关联结果;异源数据集需要开启加速引擎后在引擎中联合。建模人员应检查一对多关系会不会放大事实表行数,再决定用何种关联和聚合粒度。多表联合数据集手册给出了可用关联方式和异源联合的边界。
3 预聚合前先检查指标能否复用
金额、数量这类可加指标适合在较细粒度上保存后向上汇总。平均交付周期需要同时保存总周期和订单数,展示时再以 sum(总周期) / sum(订单数) 计算;完成率需要保存分子与分母;去重客户数、期末库存和跨期余额则要保留明细、可合并状态或明确的重算规则。直接把日均值、日完成率或日去重数继续求和,会改变业务含义。
衡石的指标、数据集和仪表盘可以让这类口径在多个入口复用。发布前,数据负责人应选定一段固定时间、工厂和产品范围,分别在明细数据集与聚合数据集上计算同一指标,并记录差异、更新时间和筛选条件。通过这次对照后,业务人员在看板、报表或受控的数据问答中使用的是同一套已确认口径,而不是各自拼接的聚合表达式。
4 加速引擎与更新决定数据何时可见
聚合数据集表达的是计算粒度,不会替团队安排源端数据如何到达分析侧。HENGSHI SENSE 可以为数据集开启加速引擎:系统将数据集数据导入引擎,查询该数据集时直接访问引擎表。官方手册也提醒,Hive、Spark、Impala、Presto、MaxCompute 等大数据源不宜大规模导入引擎,团队应按数据规模和数据源能力选择直连或导入。加速引擎手册说明了该路径及同步频率设置。
源端行数据变化后,已导入引擎的数据集需要执行数据更新才能保持时效。平台提供立即更新、更新计划与全量或增量更新设置;增量更新只适用于通过 SQL 查询或直连建立的数据集,增量字段应能标识本次需要更新的数据。复合数据集还能在更新计划中配置是否跟随上游刷新触发。团队应把最近一次成功更新时间、失败告警和上游依赖作为看板验收的一部分。数据集更新手册列出了这些入口和边界。
5 ClickHouse 增量物化视图负责插入时的结果维护
ClickHouse 的增量物化视图把计算从查询时移到插入时:源表有新数据块插入时,视图执行定义的查询,并把结果写入目标表。后续插入继续写入增量结果,目标表的引擎和查询表达式还需匹配所采用的聚合或状态合并方式。它适合把追加事实流上的聚合、筛选或转换维护在数据库层。ClickHouse 增量物化视图文档明确将该对象描述为插入数据块触发的查询,而非对任意表变化都自动响应的刷新器。
订单表与产品维表的 JOIN 能说明这个边界。若订单表位于查询最左侧,新订单插入时会触发视图;右侧产品维表会参与本次关联读取。产品名称或产品线后来发生变化时,右表变化本身不会触发视图,已有订单结果也不会自动追溯修正。更新或删除已有源数据同样不能按“任意变化触发”理解。业务若要展示当前维度属性或更正历史汇总,方案需要明确 CDC 或导入链路如何表达变更、目标表怎样重算或回补、谁负责验证修正后的口径。
部署时,数据团队先明确 ClickHouse 结果表如何供衡石连接和建模,再检查源端采集、事实写入、结果维护与看板查询各自的时点。对于追加订单,可验证插入后的金额和数量是否及时进入结果表;对于产品归类修正,则按业务需要选择保留交易当时属性,或重新计算历史数据。把这两种需求写进维护方案,既能利用插入时计算处理新增事实,也能让业务人员解释历史数字为何变化。
6 两层预计算可以组合,但职责不同
| 层次 | 处理的问题 | 订单示例中的验收点 |
|---|---|---|
| 聚合数据集 | 定义日、工厂、产品线等分析粒度,以及维度、度量和过滤条件。 | 聚合与明细的金额、数量、完成率口径一致;下钻范围符合保留粒度。 |
| 加速引擎与数据更新 | 让适合导入的数据集在引擎中查询,并按已配置动作同步源端变化。 | 最近成功更新时间、上游依赖、失败告警和权限范围可查。 |
| ClickHouse 增量物化视图 | 在已确认的数据库方案中,随事实表插入维护目标表。 | 插入、维表变更、更新删除和历史回补各有可执行的维护与校验步骤。 |
组合方式应从业务查询反推。团队可以让聚合数据集承担经营看板的标准粒度,在引擎侧按更新计划刷新数据;也可以在已验证的 ClickHouse 写入链路中维护某个追加订单流的结果表,再由 HENGSHI SENSE 接入和建模。两种选择都需要保留指标定义、数据权限、数据新鲜度和回补记录。它们共同减少重复工作,却不共享同一套触发语义。
7 按一条可验证的路线落地
- 列出经营看板要回答的问题,写清最低下钻粒度、时间范围、用户角色和新鲜度目标。
- 在 HENGSHI SENSE 中建立订单、产品和组织的数据集,预览多表关联并排查一对多放大。
- 创建聚合数据集,保留能够支撑核心指标与下钻的维度;为平均值、比率、去重和期末值写出可复用的计算状态或重算规则。
- 按数据源条件选择直连或加速引擎。启用导入后,配置并验证立即更新或更新计划,记录最近一次成功更新。
- 只有在架构确认需要 ClickHouse 增量物化视图时,再定义源表插入、维表变化、历史回补和更新删除的维护动作,并用同一批样本复核目标表。
- 用明细结果、聚合结果和最终看板做同条件对照,确认口径、权限和新鲜度,再把指标交给报表、仪表盘或受控的 HENGSHI SENSE 数据问答复用。
8 结语
预计算的价值来自可复用的分析结果,也受数据维护边界约束。HENGSHI SENSE 把聚合数据集、加速引擎、更新管理和建模能力放在同一分析工作流中,帮助团队把常用经营问题沉淀为可治理资产。ClickHouse 增量物化视图适合已确认的插入型数据库路径。把分析粒度、数据进入路径和修正策略分别设计,团队才能在追求查询效率时保持指标可信、数据可追溯。