Article body
正文
从时间问题到可复用指标
经营分析既要汇总数值,也要明确每笔数据所属的时间范围。本月累计销售额要在月初清零,去年同期 GMV 要取同一日期的基准值,用户留存要先界定基准日和观察区间。HENGSHI SENSE 把累计、对比、移动、留存和连续活跃等模式放进高级计算函数;分析师仍要定义业务对象、日期粒度和端点。把这些约定写进指标,团队才能在换图表、加维度或切换筛选时继续解释同一组数字。
| 经营问题 | 指标需要固定的时间语义 | 先核对什么 |
|---|---|---|
| 本月累计收款 | 按日汇总后,在月初重置 | 日期字段与重置周期 |
| 与七天前相比 | 当前值与指定基准日的聚合值并列 | 基准日期和缺失日期 |
| 首周留存 | 首日对象在后续观察区间再次出现 | 用户标识、起止端点和分母 |
1. 累计:先聚合,再按周期重置
date_accumulate 适合回答 MTD、QTD、YTD 这类问题。它的第一参数有两层聚合:内层先在日期粒度上完成基础汇总,外层再沿时间序列累计。日期表达式必须与图表中的时间维度一致;若在 summarize 中使用,也要把该日期表达式放在非聚合参数中。重置周期可选 hour、day、week、month、quarter、year。
date_accumulate(sum(sum({order_amount})), day({order_date}), 'month')例如,示例数据中某月前三日的日订单额依次为 100、120、80,那么该指标的显示结果应为 100、220、300。这个例子只说明口径,实际项目还要确认退款、取消单和时区归属。HENGSHI 的图表高级计算也提供累计配置;图表层的日期维度与粒度仍是结果的一部分。
2. 对比:基准值、当前值和增长率要分开
date_compare 用显式日期表达式取对比基准的聚合结果。它不直接返回增长率,也不把当前值与基准值相减。若 1 月 8 日的 GMV 是 130,七天前同日的 GMV 是 100,下面的表达式返回 100;报表要展示增长率时,再按照业务认可的公式用当前值和基准值计算,示例为 (130 - 100) / 100 = 30%。
date_compare(sum({gmv}), day({biz_date}), dayadd(day({biz_date}), -7))previous 则配合图表时间轴取前一比较周期的值。它可指定 year、quarter、month、week、day、hour 和整数偏移;省略粒度时,系统采用图表中最小的时间轴粒度。它不是“上一行”:官方示例中 1 月 7 日之后直接出现 1 月 9 日,1 月 9 日的日对比结果为空。业务人员看到空值时,应先判断缺的是原始数据、日期成员还是需要的基准期,再决定是否补齐日期或调整展示。
3. 在日期粒度上表达滚动统计
date_shift 按时间序列逐项推移,并在前后偏移范围内进行统计。第一参数同样要求外层计算和内层基础聚合;前、后偏移量是数值参数。在日期完整、按日分组的示例中,下面的表达式用于当前日及此前 6 日的日汇总均值,可用于观察交易额的平滑走势。
date_shift(avg(sum({gmv})), day({biz_date}), -6, 0)举例说,连续三日的日 GMV 为 100、120、80 时,三日窗口的均值为 100。用这个小样本可以检查公式和图表粒度是否对齐。日期断档时,团队应先约定空缺代表零值、未营业还是数据未到齐;不能仅凭 “-6 到 0” 就假定缺失日已按零计入、均值分母恒为 7。团队应检查窗口边界、数值参与和空值表现,再给图表命名。图表移动计算要求日期作为维度,并限制可用的日期聚合方式;这些条件应与指标定义一起交付。
4. 留存与连续活跃:端点和观察周期决定问题本身
retention 在日期维度下返回指定时间内的留存数或活跃数。若业务定义为“用户在首日之后第 1 至第 7 天内至少出现一次”,上界要写成实际结束日的下一天。下面的示例以用户 ID 作为统计对象、以事件日作为时间维度;留存率还需另行定义分母,不能把留存数改成百分比格式就当作留存率。
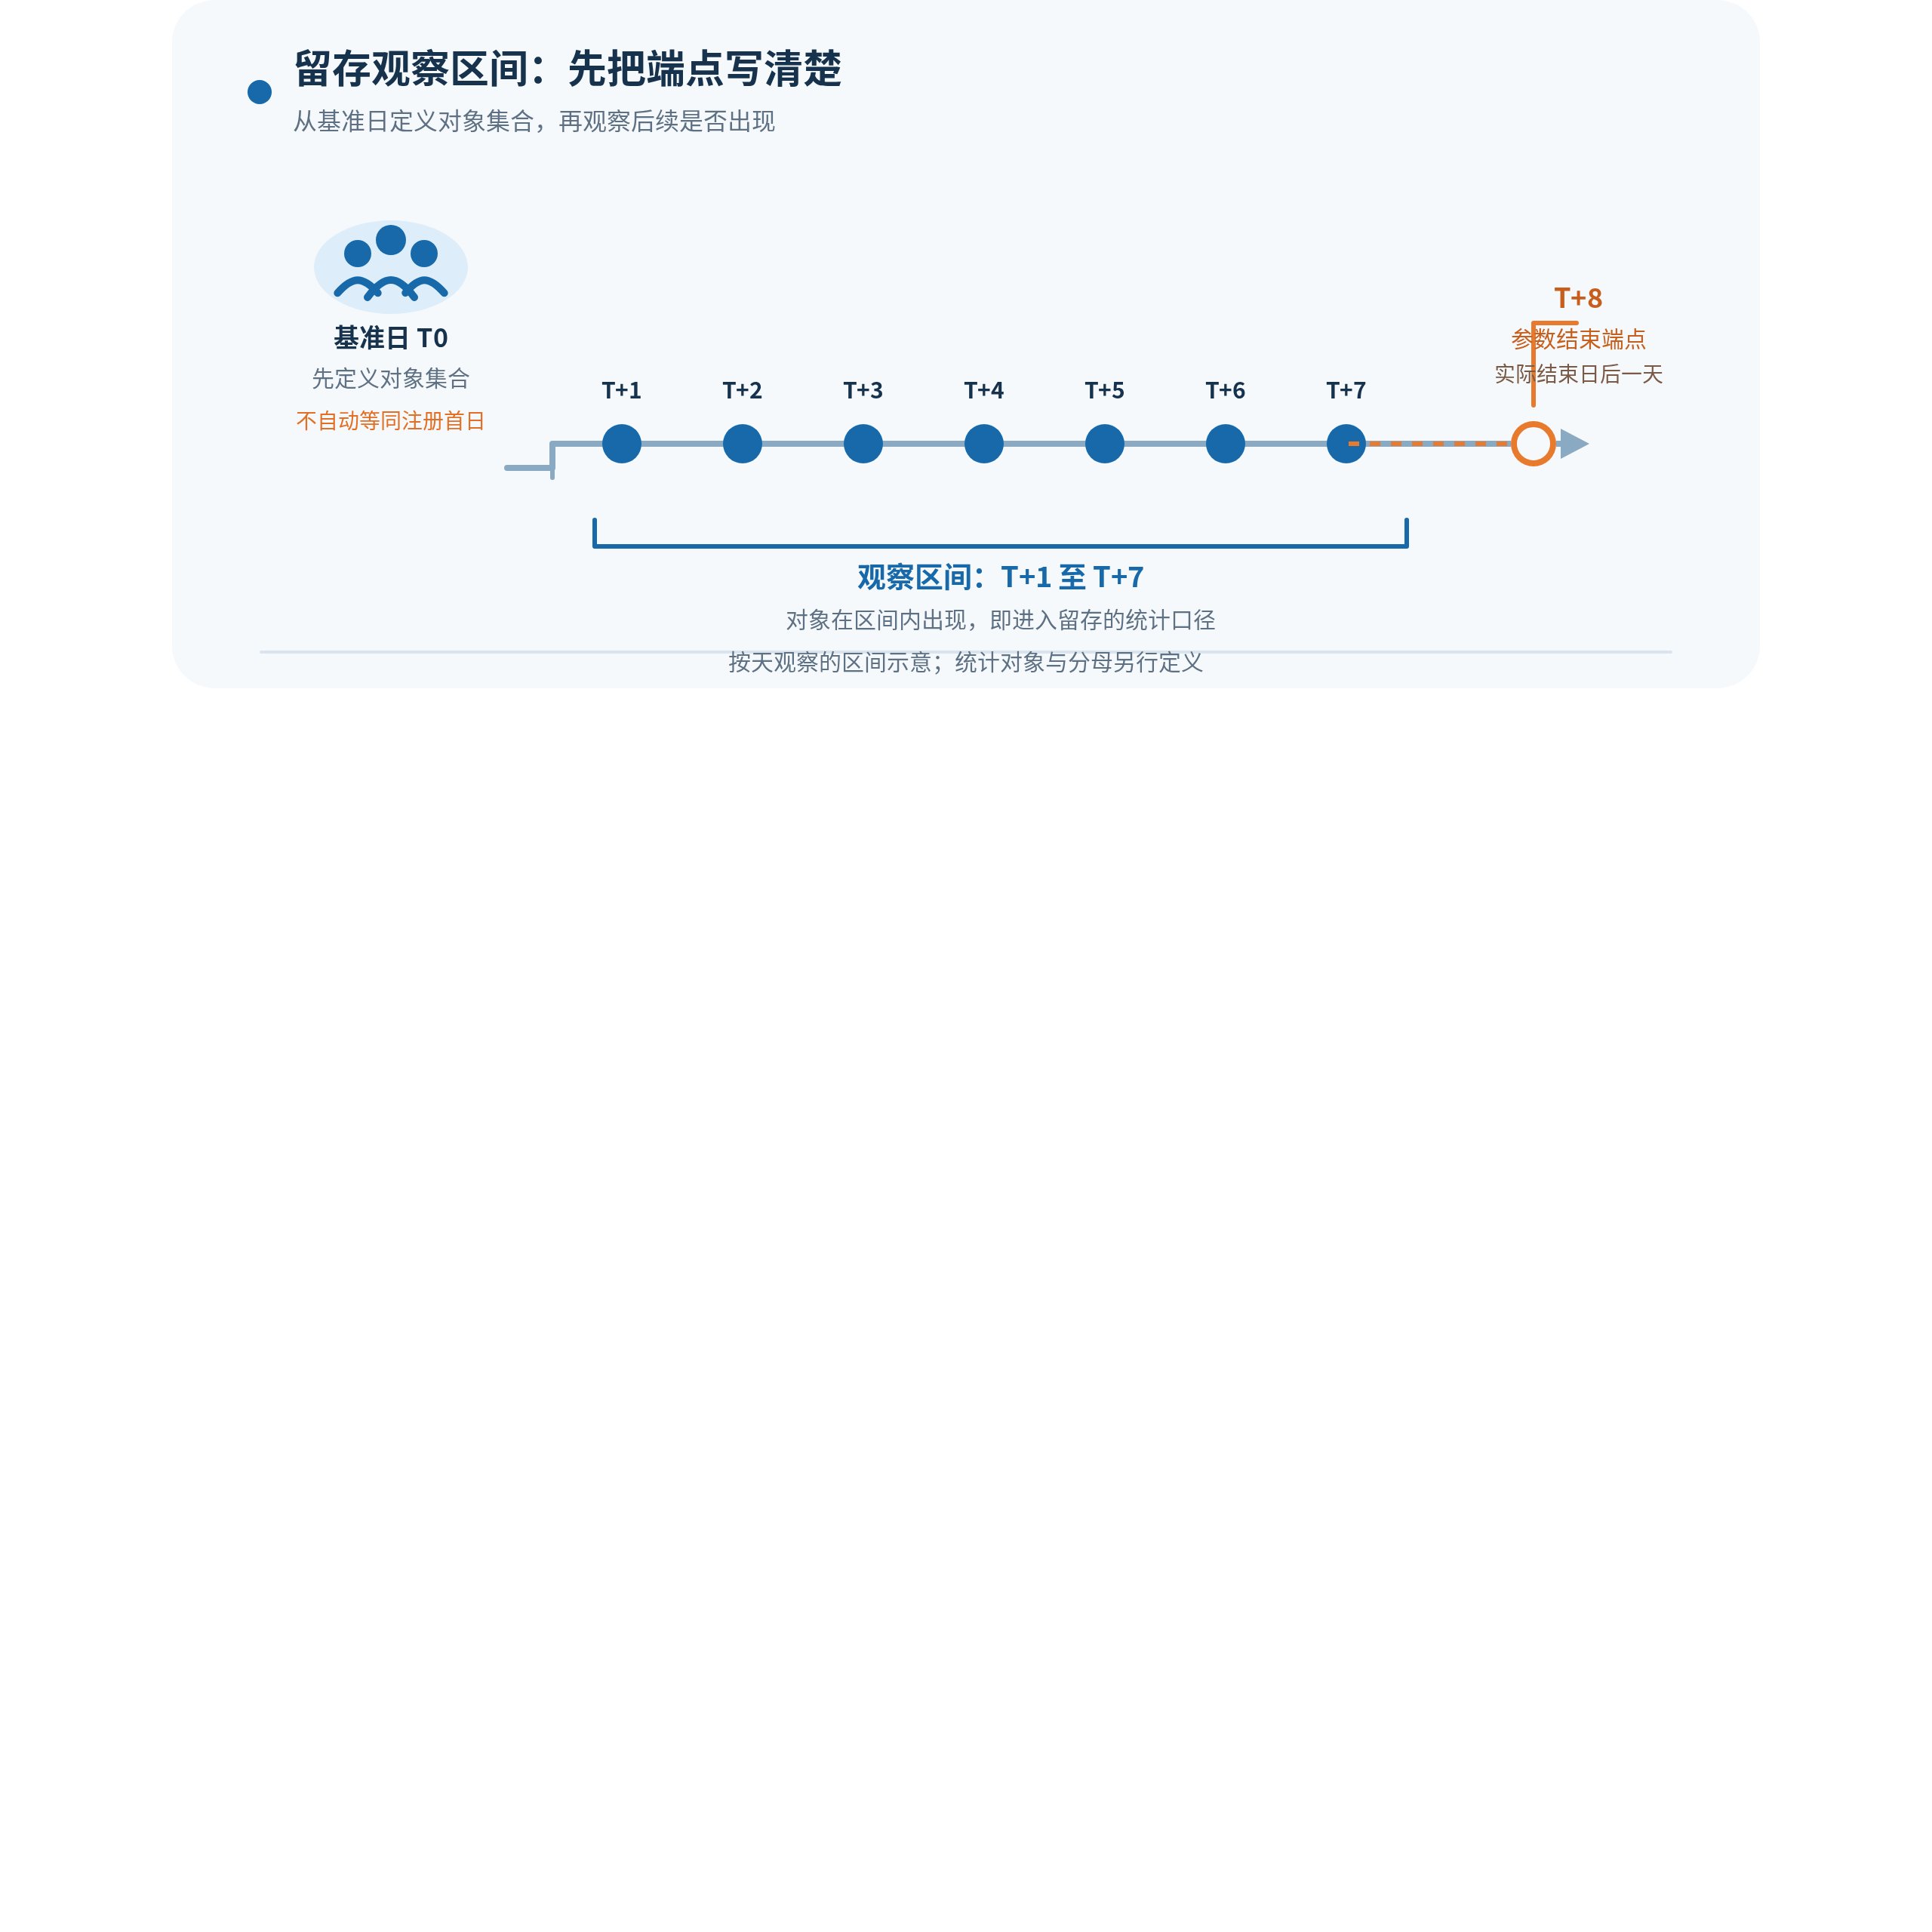
retention({user_id}, day({event_time}), dayadd(day({event_time}), 1), dayadd(day({event_time}), 8))函数的四个可选条件参数也表达日期区间:包含开始、包含结束、排除开始、排除结束。它们必须按固定顺序同时提供,或同时省略,并非四个布尔开关。continuous_retention 用于连续活跃,除了相同的日期维度和端点规则,还必须指定 period,取值为 day、week、month、quarter、year。应先让“连续”对齐业务日历,再选择函数。
渠道、区域或版本等非时间维度的留存可用 static_retention 系列分组展示。static 指输出维度不以时间为主,并不取消日期表达式和两个比较区间:函数仍需要对象、日期字段、开始与结束日期,以及比较开始与结束日期;两个结束日期都要比实际结束日多一天。
5. 把函数表达式沉淀为可维护指标
在 HENGSHI SENSE 中,时间相关高级计算可以从函数表达式沉淀到新增指标,再由图表承担维度、筛选和呈现。图表侧支持同环比、累计、移动、留存、活跃等高级计算,但支持范围受数据源、日期字段和日期聚合方式影响。新增维度还会作为过滤条件参与计算,因此“同一公式”在不同图表里并不自动代表同一经营口径。
一份可复用指标定义至少写明:统计对象和去重方式、基础聚合、日期字段与粒度、重置或比较区间、分母和空值规则、默认筛选,以及目标图表需要保留的维度。交付前可用一组小样本逐项检查累计重置、基准期缺失、留存端点和日期断档,再在目标数据源与图表粒度下复核结果。这样,业务用户拿到的是能解释、能复查、能继续使用的经营指标。
6. 在一张经营看板中协同判断
以产品线日 GMV 为例,经营负责人可以在同一张看板上放置日 GMV、月累计、七天前基准值和滚动均值。日 GMV 回答今天发生了什么;date_accumulate 显示本月目标缺口是否在收窄;date_compare 把今天放回可指定的历史基准;date_shift 则帮助团队区分单日波动与一段时间内的变化。四个数字共用同一个日期字段和基础聚合,读者才不会把不同颗粒度的数放在一起比较。
例如,某日 GMV 低于七天前,但月累计仍接近目标,且在日期完整的样本中滚动均值没有同步走低,团队可以先检查当天的促销、库存或渠道事件,而不是把单日变化直接解读为月度趋势。反过来,若基准对比、累计缺口和滚动均值都指向同一方向,再下钻到渠道、区域或商品维度。下钻后的图表要保留原指标的日期粒度和筛选说明,因为新增维度会参与高级计算。这样的指标组合把复盘路径留在看板里,也让后续报表复用同一套经营语言。
把时间口径纳入指标交付
时间函数缩短了表达式,却不会替团队决定经营定义。HENGSHI SENSE 的价值在于把累计、对比、移动和留存这些高频模式变成可以组合和复用的分析能力。先把时间轴、端点、对象和分母说清楚,再把公式与图表规则一并沉淀为指标,时间序列才会从一次性报表走向稳定的经营分析资产。