
Article body
正文
RAG解决了一个重要问题:大模型无法在训练阶段知道企业私有数仓的表名、字段和指标口径。系统在用户提问时检索相关Schema与业务知识,再把这些上下文交给模型。它提高了命中率,却不能单独保证查询正确。
第一层:检索内容必须来自治理资产
知识库应收录经过维护的数据集说明、指标定义、同义词和示例查询。把全部DDL和历史文档直接向量化,会让过期字段与草稿口径混入检索结果。每条知识需要版本、负责人和有效范围,Schema变更后及时重建索引。
第二层:语义检索要结合结构过滤
向量相似度擅长找“意思相近”,却可能返回无权限的数据集或粒度不兼容的指标。检索阶段需要先按租户、用户权限、业务域和数据版本过滤,再做向量召回。多语言企业还要维护中英文术语映射,避免同一指标在不同语言下命中不同对象。
第三层:生成前完成口径消歧
Agent发现多个“收入”指标时,应展示候选定义或根据当前应用限定范围。时间、组织、币种和税口径缺失时,系统需要追问。一次简短确认可以省掉后续报表返工。
第四层:执行后校验结果
SQL通过语法检查仍可能产生错误业务结果。平台可以验证空结果、数量级、时间范围、聚合粒度和权限过滤。高风险指标还应与已认证报表交叉核对。异常结果进入修正流程,不直接生成肯定式结论。
第五层:保留反馈与审计
用户对答案的修正需要回到知识库、指标定义或示例库,不能只存成一条聊天记忆。审计记录应包含问题、检索内容、使用指标、生成查询、执行身份和最终输出。团队据此区分检索失败、语义失败和执行失败。
模型选择排在工程之后
更大的模型可以改善语言理解和复杂推理,却无法修复混乱的指标口径。企业先建设治理资产、权限过滤和结果校验,再比较模型成本、延迟与部署方式。私有化场景还要评估向量模型、向量库备份和离线更新机制。可信ChatBI来自整条链路的约束,不来自某一个模型名称。
工程细节与实施补充
一、为什么需要RAG?ChatBI的准确率困境
1.1 纯LLM方案的固有局限
在深入HENGSHI SENSE的AI架构之前,需要先理解一个核心工程问题:为什么纯LLM方案在BI场景中无法达到生产级准确率?
企业级数据分析场景有以下几个独特的约束条件:
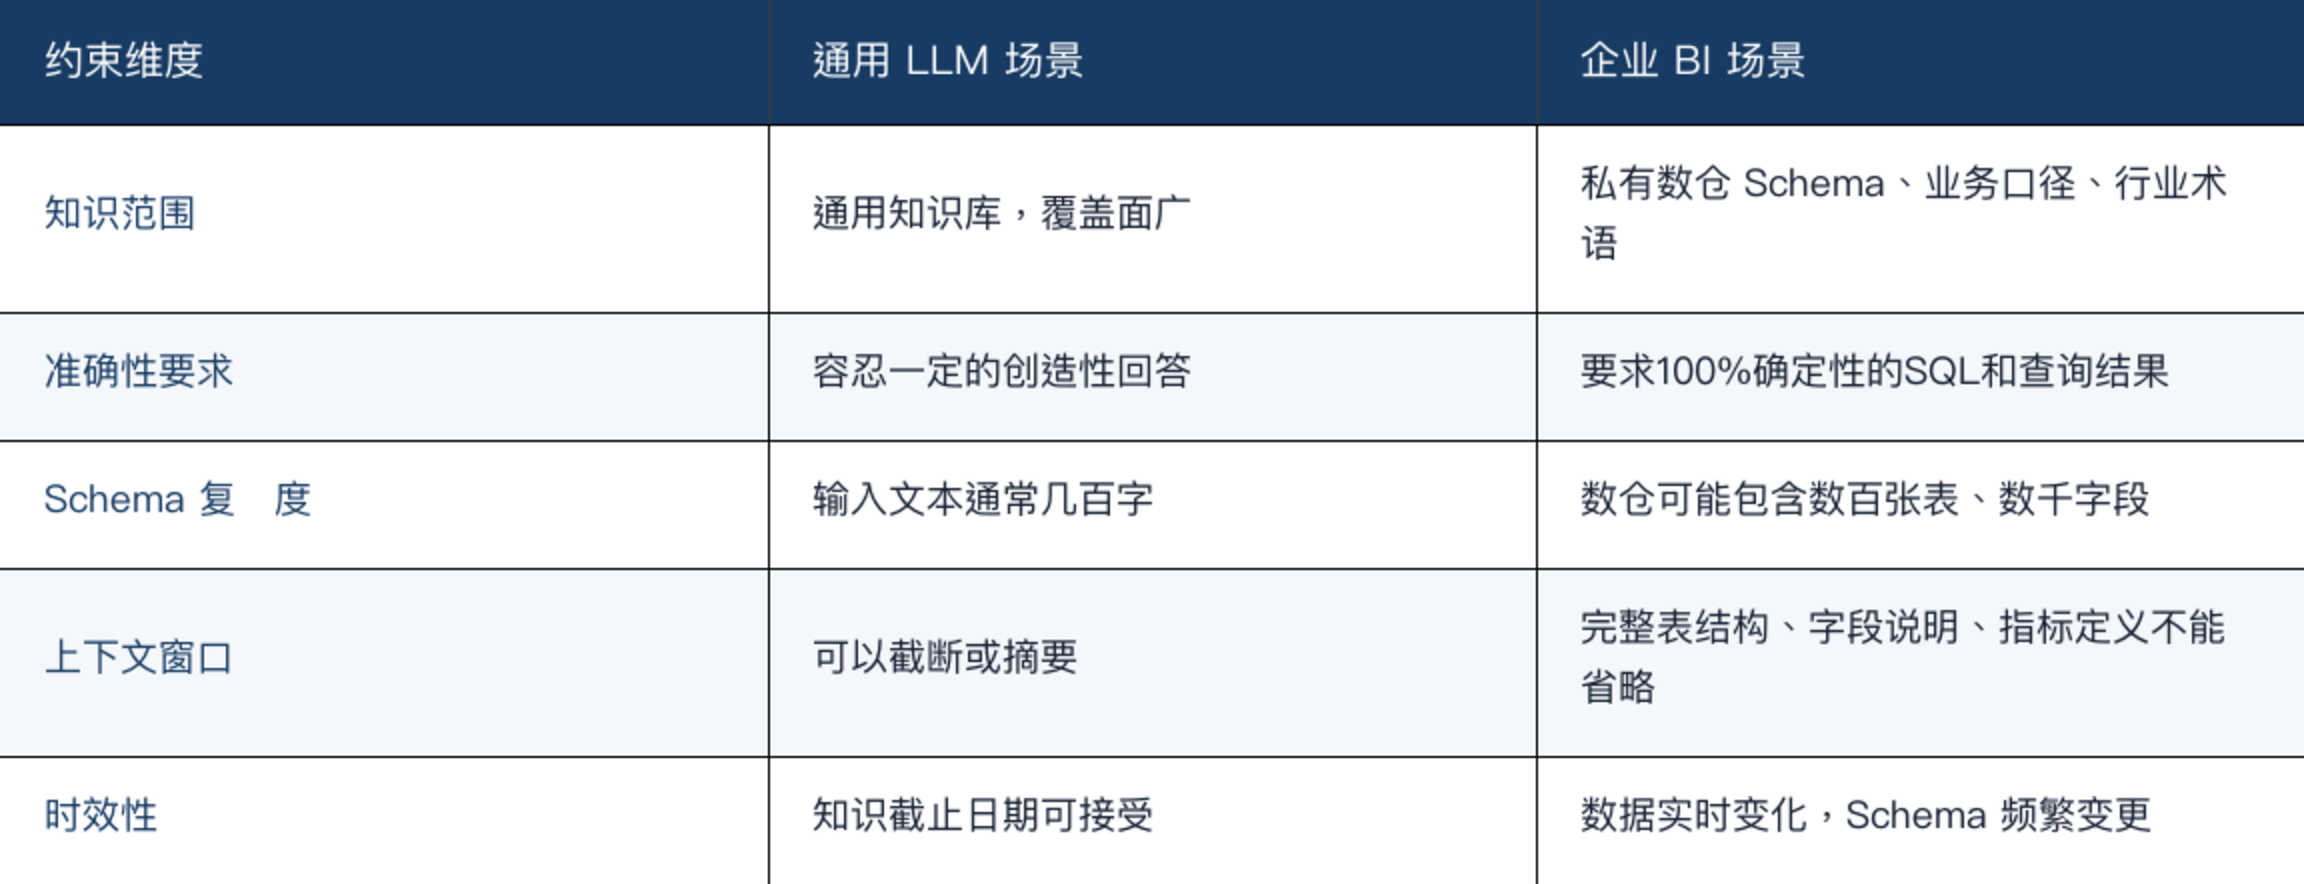
纯LLM方案的核心问题在于:它试图用“参数化知识”(训练时学到的知识)来处理“非参数化知识”(企业私有数仓的Schema和业务口径)。这两者的本质不兼容:数仓的表名、字段名和业务含义是任意且企业独有的,LLM不可能在训练阶段学到。
1.2 RAG架构的技术优势
RAG(Retrieval-Augmented Generation,检索增强生成)架构的核心思路是:不要让LLM记住企业私有知识,而是在推理时把相关知识交给它。
在BI场景中,RAG的典型工作流如下:
用户提问:"上个月华东区的GMV是多少?"
        │
        ▼
┌─────────────────────────────────────────┐
│ Step 1: 问题向量化                        │
│   将自然语言问题编码为高维向量             │
└──────────────┬──────────────────────────┘
               ▼
┌─────────────────────────────────────────┐
│ Step 2: 向量检索                         │
│   在知识库中检索与问题语义最相关的         │
│   表结构、字段说明、指标定义               │
└──────────────┬──────────────────────────┘
               ▼
┌─────────────────────────────────────────┐
│ Step 3: 上下文组装                        │
│   将检索到的知识+用户问题组装为prompt      │
└──────────────┬──────────────────────────┘
               ▼
┌─────────────────────────────────────────┐
│ Step 4: LLM生成SQL                       │
│   基于精准上下文生成确定性的SQL语句        │
└──────────────┬──────────────────────────┘
               ▼
┌─────────────────────────────────────────┐
│ Step 5: 执行与验证                        │
│   执行SQL并返回查询结果给用户             │
└─────────────────────────────────────────┘
这种架构的工程优势包括:
- 知识实时更新:数仓Schema变更后,只需重新向量化知识库,无需重新训练模型
- 知识精准注入:只检索与当前问题相关的Schema片段,避免上下文爆炸
- 可追溯可审计:每次查询使用的知识来源可追溯,便于问题诊断
二、向量库服务架构:从组件选型到生产部署
2.1 HENGSHI SENSE向量库的架构设计
HENGSHI SENSE的向量检索服务由两个核心组件构成:
┌──────────────────────────────────────────────────────────┐
│                  HENGSHI SENSE AI Architecture            │
│                                                          │
│  ┌────────────┐    ┌──────────────────┐                   │
│  │ vector-    │    │ vector-postgres  │                   │
│  │ serve      │◄──►│ (pgvector)       │                   │
│  │            │    │                  │                   │
│  │ Embedding  │    │ 向量存储 &       │                   │
│  │ Service    │    │ 相似度检索        │                   │
│  └─────┬──────┘    └────────┬─────────┘                   │
│        │                    │                             │
│        │ HTTP API           │ JDBC                        │
│        │ /v1/embeddings     │                             │
│        ▼                    ▼                             │
│  ┌─────────────────────────────────────┐                  │
│  │         HENGSHI SENSE Core           │                  │
│  │                                     │                  │
│  │  AI Assistant Module                 │                  │
│  │  ├── Question Understanding          │                  │
│  │  ├── Knowledge Retrieval (RAG)       │                  │
│  │  ├── SQL Generation (LLM)            │                  │
│  │  └── Result Validation               │                  │
│  └─────────────────────────────────────┘                  │
└──────────────────────────────────────────────────────────┘vector-serve负责文本向量化(Embedding)的推理服务。它接收文本输入,调用嵌入模型生成高维向量表示。
vector-postgres基于PostgreSQL和pgvector扩展,负责存储数据集元数据、指标定义、字段说明等知识的向量表示,并提供近似最近邻(ANN)检索能力。
2.2 嵌入模型选型:为什么选multilingual-e5-base
HENGSHI SENSE的向量服务默认使用intfloat/multilingual-e5-base模型,这是一个基于Transformer架构的多语言文本嵌入模型。选型考量如下:
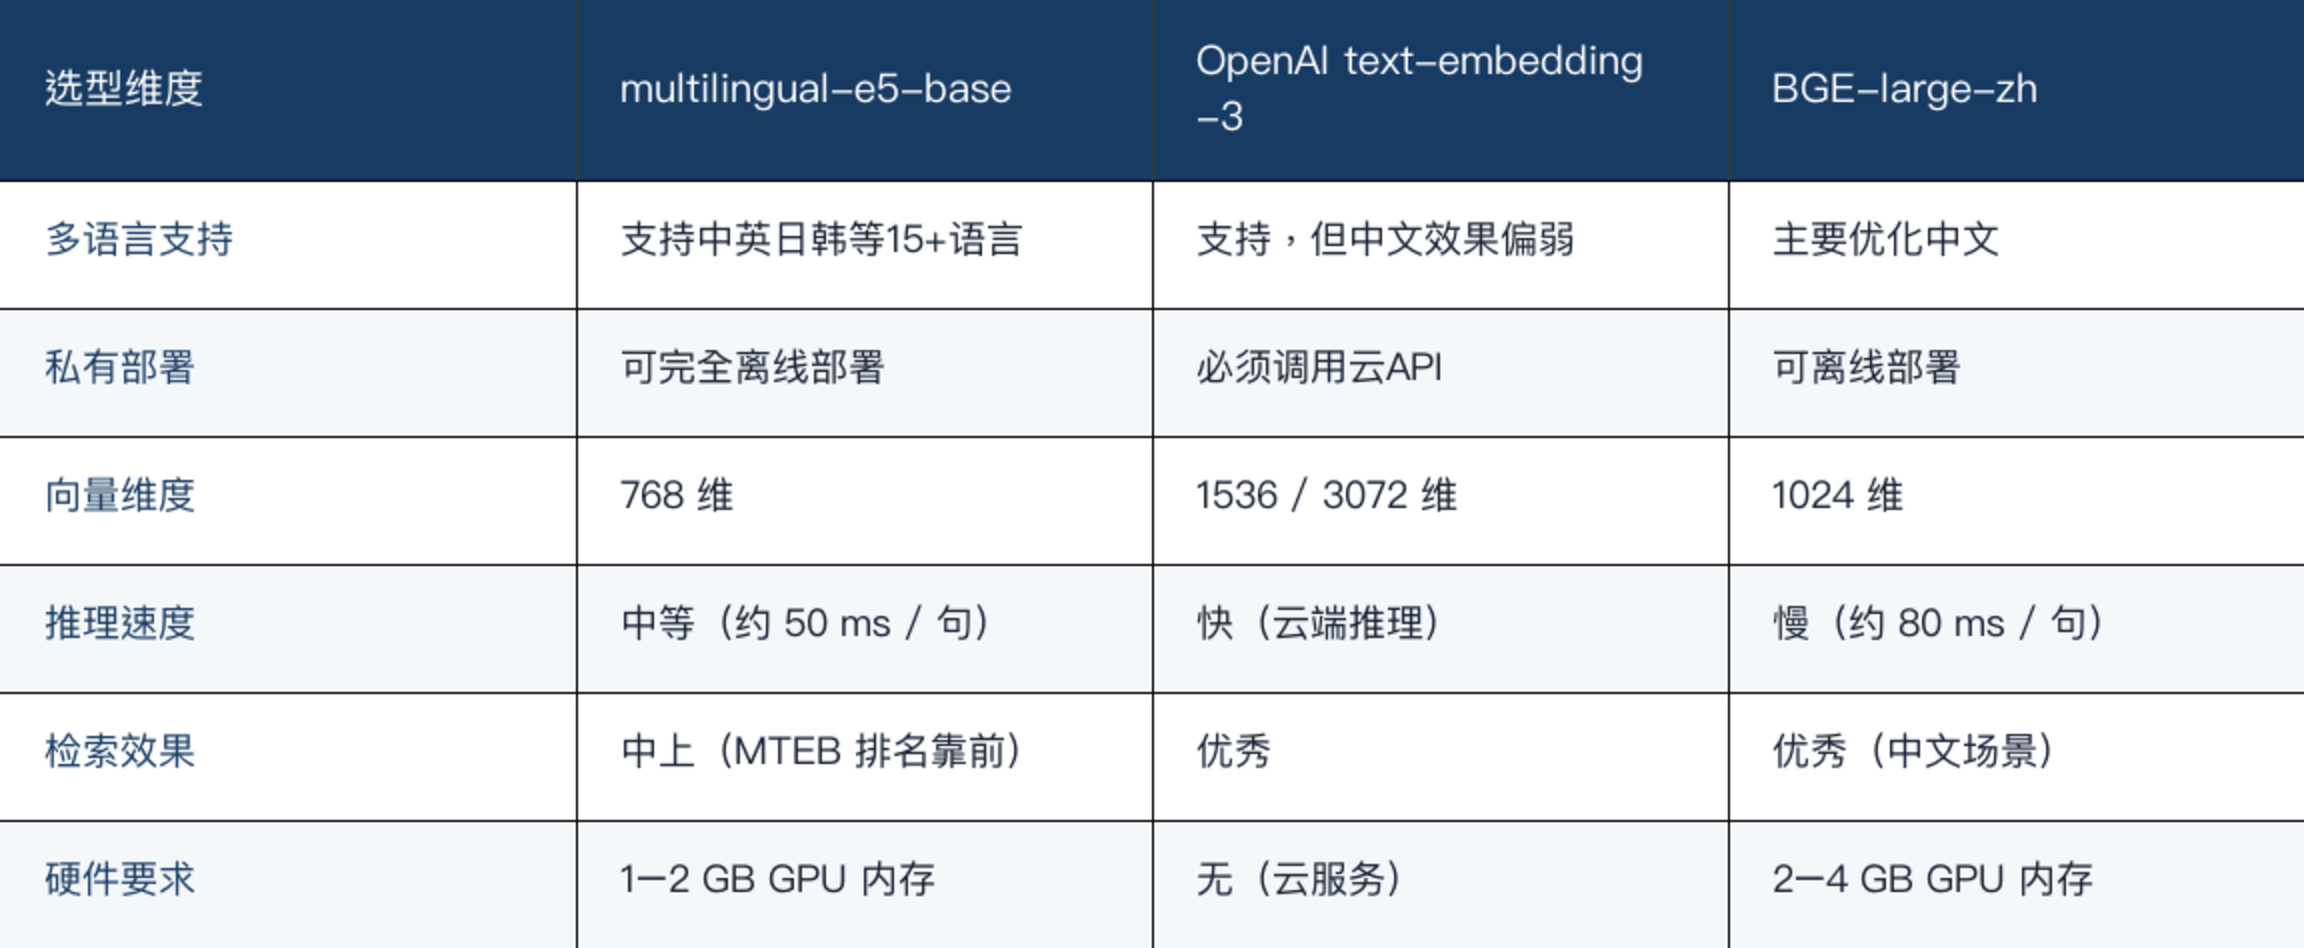
对于企业级BI PaaS场景,multilingual-e5-base的选择是合理的:
- 企业客户通常有数据不出域的合规要求,私有部署是刚需
- 多语言能力满足跨国企业的需求
- 768维向量在检索精度和存储、计算成本之间取得平衡
2.3 部署方式一:脚本部署(单机/Docker Compose)
在HENGSHI SENSE核心服务中配置向量服务的连接信息。
单节点部署:
# 编辑环境配置文件
vi /opt/hengshi/conf/hengshi-sense-env.sh

# 添加以下配置
export VECTOR_DB_URL="jdbc:postgresql://<VECTOR_PG_HOST>:54321/postgres"
export VECTOR_ENDPOINT="http://<VECTOR_SERVE_HOST>:3000/v1/embeddings"
Docker Compose部署:
# 在.env文件中添加
VECTOR_DB_URL=jdbc:postgresql://vector-postgres:5432/postgres
VECTOR_ENDPOINT=http://vector-serve:3000/v1/embeddingsKubernetes部署:
# 编辑configmap
kubectl -n hengshi edit configmap hengshi-senseapiVersion: v1
kind: ConfigMap
metadata:
name: hengshi-sense
namespace: hengshi
data:
VECTOR_DB_URL: "jdbc:postgresql://vector-postgres:5432/postgres"
VECTOR_ENDPOINT: "http://vector-serve:3000/v1/embeddings"2.6 部署验证与故障排查
部署完成后,先验证vector-serve嵌入服务:
curl -X POST http://localhost:3000/v1/embeddings \
  -H 'Content-Type: application/json' \
  -d '{"input": ["上个月华东区的销售额"], "model": "intfloat/multilingual-e5-base"}'
期望返回包含嵌入向量和模型信息的JSON:
{
  "object": "list",
  "data": [
    {
      "object": "embedding",
      "embedding": [0.0123, -0.0456, 0.0789],
      "index": 0
    }
  ],
  "model": "intfloat/multilingual-e5-base",
  "usage": {
    "prompt_tokens": 12,
    "total_tokens": 12
  }
}
验证vector-postgres向量检索:
-- 进入PostgreSQL
psql -h localhost -p 54321 -U postgres -d postgres

-- 验证pgvector扩展
SELECT * FROM pg_extension WHERE extname = 'vector';

-- 测试向量检索
SELECT vectorize.transform_embeddings(
  input => '测试嵌入',
  model_name => 'intfloat/multilingual-e5-base'
);
常见故障包括:
| 错误信息 | 可能原因 | 解决方案 |
|---|---|---|
query vector db fail | vector-serve和vector-postgres通信故障 | 分别验证两个服务的健康状态和网络连通性 |
connection refused | 端口未开放或防火墙限制 | 检查防火墙规则和网络策略 |
model not found | 模型文件未正确加载 | 重新执行模型文件复制和解压步骤 |
out of memory | GPU内存不足 | 减少vector-serve副本数或增加GPU资源 |
五、工程最佳实践
5.1 向量库运维建议
| 实践项 | 建议 | 原因 |
|---|---|---|
| 知识库更新频率 | Schema变更后立即重新向量化 | 避免检索到过时的表结构信息 |
| 向量索引类型 | 使用IVFFlat或HNSW索引 | 平衡检索精度和查询延迟 |
| 监控指标 | 向量检索延迟、检索召回率、嵌入服务QPS | 及时发现性能瓶颈 |
| 数据备份 | 定期备份vector-postgres | 向量数据重建成本高 |
5.2 模型选型建议
| 场景 | 推荐模型 | 原因 |
|---|---|---|
| 高并发简单查询 | DeepSeek / Groq | 低延迟、高吞吐 |
| 复杂分析任务 | Claude 3.5 / GPT-4o | 强推理能力 |
| 完全离线部署 | Qwen2.5-27B / GLM-5 | 私有化支持好 |
| 预算有限 | MiniMax-M2.5 | MoE架构性价比高 |
| 中文场景 | DeepSeek / 通义千问 | 中文理解和生成质量高 |
5.3 准确率优化策略
- 指标语义层对齐:确保向量知识库中的指标定义与指标平台保持同步
- 业务术语映射:为行业术语建立标准化的同义词表,提升检索召回率
- Few-shot示例库:为常见查询模式准备示例问答对,在prompt中提供上下文
- 结果校验层:在SQL执行后增加结果合理性校验,拦截明显的异常结果
- 用户反馈闭环:记录用户对AI回答的评价,持续优化prompt和检索策略
六、总结
HENGSHI SENSE通过vector-serve和vector-postgres把企业Schema、指标定义与业务术语纳入RAG检索链路。生产可用性还依赖权限过滤、口径消歧、结果校验、索引更新和审计反馈。企业应先建立这些工程控制,再根据延迟、成本和部署边界选择模型。
资料与核验说明
内部资料用于梳理衡石能力与工程方法;竞品和版本信息按2026年8月26日可访问的官方页面复核。产品功能会受版本、地区、授权和部署模式影响,正式采购与发布前应再做一次现场确认。
延伸阅读:HENGSHI SENSE产品与技术白皮书。